
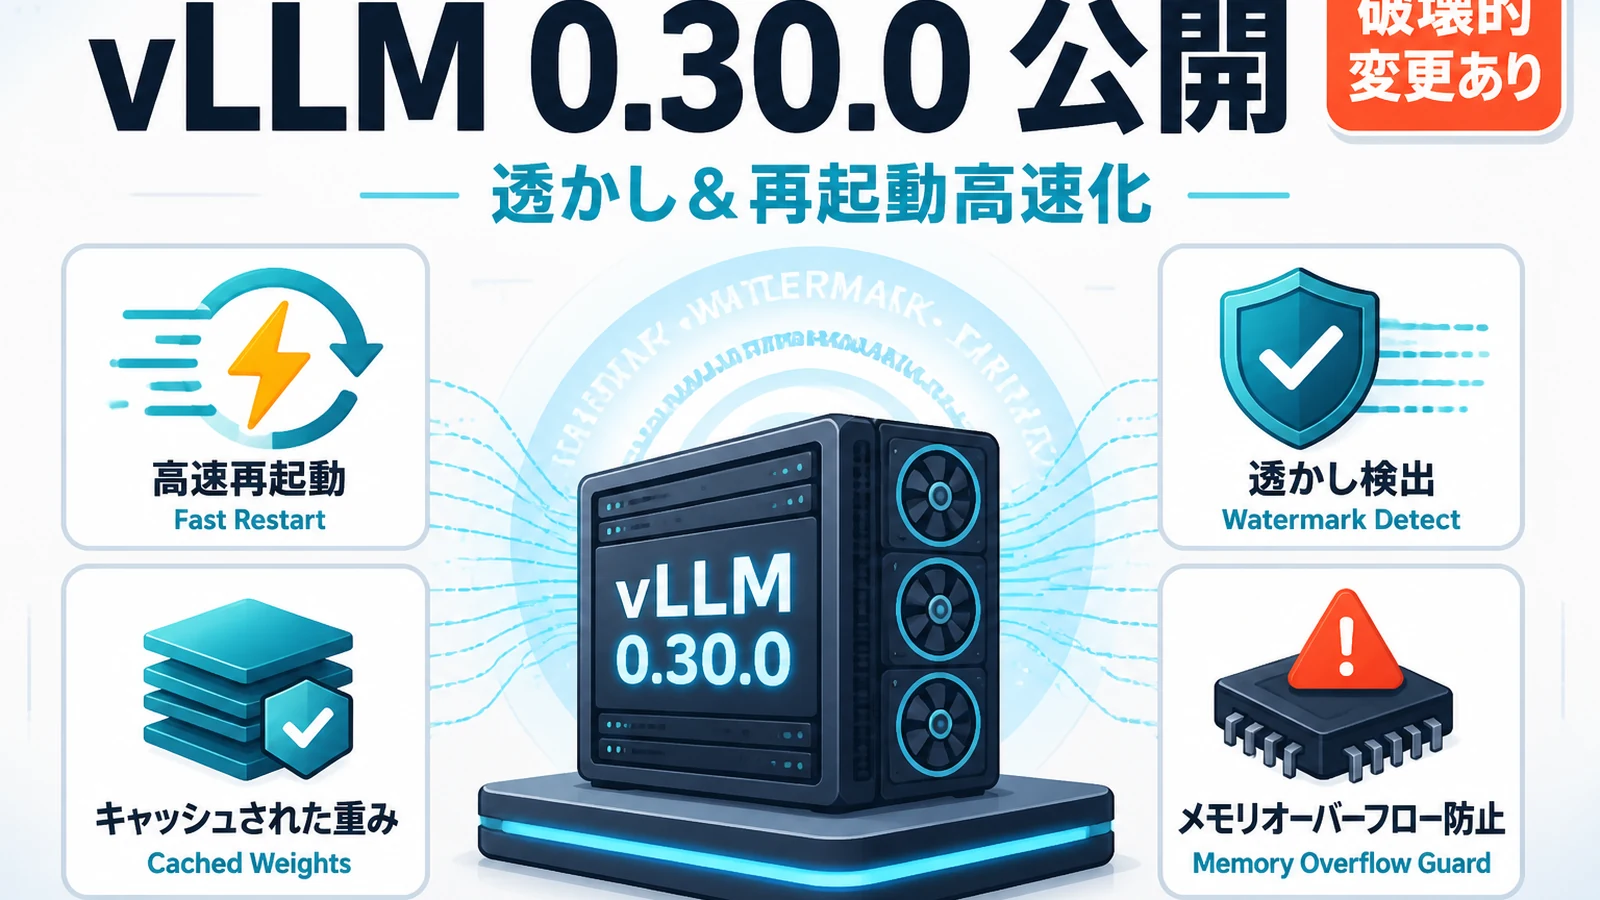


vLLM 0.30.0 は、LLM推論・サービングエンジン vLLM が2026年9月22日に公開したリリースで、電子透かしとFast Startを中心に運用まわりの機能が追加されました。
📖 この記事で分かること
- vLLM 0.30.0が2026年9月22日に公開された
- 生成テキストへの電子透かし埋め込みと検出に対応
- 重みをGPUに常駐させ再起動時の再読込を省く仕組み
- 既定値の変更など、更新時に踏む破壊的変更
💡 知っておきたい用語
- 推論エンジン: 学習済みのAIモデルを実際に動かして応答を返す土台のソフトウェア。同じモデルでもこれを替えると速度や同時接続数が変わる
最終更新日: 2026年9月23日
▶ 公式ページ
- vLLM v0.30.0 リリースノート(GitHub)
- vLLM 公式ドキュメント(vLLM)
- vLLM リポジトリ(GitHub)
vLLM 0.30.0で何が変わったか
この記事のポイント
- vLLM 0.30.0(2026年9月時点)が2026年9月22日に公開。315人が参加し762コミットを含みます。
- 生成テキストへの電子透かしと、重みをGPUに残して再起動を速くするFast Startが加わりました。
- スケールアウト用エンドポイントが既定で無効になるなど、更新時に設定変更が要ります。
vLLMは、学習済みのLLMをサーバー上で動かして応答を返す推論・サービング用のオープンソースソフトウェアです。今回の0.30.0では、生成物の出所を判別する電子透かし、起動の待ち時間を削る重みキャッシュ、GPUメモリが逼迫したときの退避先を確保する仕組みが同時に入りました。リリースには315人のコントリビュータ(うち104人は新規)による762コミットが含まれます。
自前でモデルを動かしている側から見ると、今回は「推論を速くする」だけの更新ではありません。運用上の面倒(再起動の遅さ、GPUメモリの上限、生成物が自社モデル由来かどうかの判別)に手が入っています。
追加された3つの新機能
新機能は、起動時間・生成物の判別・メモリ逼迫時の挙動という、運用で詰まりやすい3点に対応しています。
Fast Startは、GPUごとに常駐する重みキャッシュのデーモンを置く仕組みです。量子化とテンソル並列の分割を済ませた重みをGPUメモリに保持しておき、エンジンを再起動しても --load-format ipc_cache を指定すればCUDA IPC経由でその重みをマップできます。ディスクからの再読み込みが不要になり、FP4チェックポイントと複数ノードでのテンソル並列にも対応します。
ウォーターマーク(電子透かし)は、鍵付きPRFを使うGumbel-max方式で、生成テキストへの透かし埋め込みと検出の両方に対応しました。リクエスト単位でのオプトアウトができ、検出用エンドポイントのサンプル実装が付属します。2つの鍵を使うdual-key Gumbel-maxにより、投機的デコードと併用しても動作します。
HiSparseは、sparse-MLAデコード向けにホスト常駐の階層を設けるものです。GPUが逼迫するとKVページをピン留めしたホストメモリへ退避し、top-kで外れた分はリクエストごとのGPUホットバッファから返します。HiSparseConnector で有効にします。
起動まわりでは、Model Runner V2がCUDAグラフのキャプチャ中にGC(ガベージコレクション)を凍結するようになり、H200上でキャプチャが12秒から2秒へ、エンジン初期化が28.9秒から8.2秒へ短縮されたと記載されています。
対応モデルも広がり、DeepSeek-V4.1-Flash、GLM-5.3-Flash、K2-Horizon、Cohere Compassなどが加わりました。DeepSeek-V4向けにはAVX512/AMXを使うCPUバックエンドも用意されています。Kimi K3向けでは、KDAのmixed-batch gather/scatterを除いたことで実効スループットが5.2〜7.7%向上し、grouped FP8 MLAキャッシュ挿入により小バッチ時のカーネルが4〜6倍速くなったとされています。
アップグレード時に踏む破壊的変更
0.30.0には設定の書き換えが必要な変更が複数入っており、そのまま上げると起動しない構成があります。
- スケールアウト用エンドポイントは
vllm serveでは既定で無効になり、--enable-scale-outの指定が要ります(従来の環境変数VLLM_ENABLE_SCALE_OUT_ENDPOINTSを置き換え) - GPTQのactivation ordering(
g_idx)が削除されました - 0.29で非推奨だった項目が削除され、環境変数
VLLM_PREFIX_CACHE_RETENTION_INTERVALとVLLM_MM_HASHER_ALGORITHMなどが使えません python -m vllm.entrypoints.grpc_serverは非推奨となり、vllm serve --grpcへ移行します- YaRNの挙動がTransformersに合わせられ、ベンダー独自のYaRNエイリアスは
max_model_lenを再スケールしなくなりました
配布はPyPI(CUDA 13.0)のほか、ROCm・XPU向けwheelとDockerイメージが用意されます。Dockerは vllm/vllm-openai:v0.30.0 を基本に、CUDA 12.9版、Ubuntu 24.04版、ROCm版、CPU版、XPU版が公開されています。
編集部の見方
編集部は、この更新で実務にいちばん効くのは電子透かしではなくFast Startだと見ます。透かしは使う側の判断と運用設計が要る機能ですが、起動の速さは設定を1つ足すだけで全員に効くためです。
- 根拠1: 重みをGPUに常駐させることで、再起動時にディスクからの再読み込みが不要になります。モデル入れ替えや障害復旧のたびに待たされる時間が、運用コストそのものになっている環境は少なくありません。
- 根拠2: 別経路の改善もそろっています。GCの凍結でエンジン初期化が28.9秒から8.2秒へ短縮されたと記載されており、起動時間の短縮が単発の工夫ではなく全体の方向性として扱われています。
- 根拠3: 電子透かしは、リクエスト単位のオプトアウトと検出用サンプルが付く一方、鍵の管理と検出側の運用を自前で設計する必要があります。入れれば効く類の機能ではありません。
この見方が変わる条件は、生成物の出所表示が規制や取引先要件として求められるようになった場合です。そのときは透かしが「あると速い」ではなく「無いと使えない」機能に変わり、優先順位が入れ替わります。
よくある質問
Q: Fast Startを使うと、どの作業が不要になりますか
A: エンジンの再起動時に、ディスクから重みを読み直す処理が不要になります。GPUごとに常駐するデーモンが量子化・テンソル並列分割を済ませた重みをGPUメモリに保持し、--load-format ipc_cache を指定するとCUDA IPC経由でその重みをマップします。
Q: 電子透かしは投機的デコードと併用できますか
A: 併用できます。2つの鍵を使うdual-key Gumbel-max方式により、投機的デコードとの組み合わせに対応したとリリースノートに記載されています。
Q: 0.29から上げるとき、特に注意する点はどこですか
A: スケールアウト用エンドポイントが既定で無効になった点です。vllm serve で使う場合は --enable-scale-out の指定が必要で、従来の環境変数 VLLM_ENABLE_SCALE_OUT_ENDPOINTS は置き換えられました。あわせてGPTQの g_idx 削除と、0.29で非推奨だった環境変数の削除も確認が要ります。
まとめ
vLLM 0.30.0は2026年9月22日に公開され、315人による762コミットを含みます。生成テキストへの電子透かし、重みをGPUに常駐させて再起動を速くするFast Start、GPU逼迫時にKVページをホストメモリへ退避するHiSparseが加わりました。一方でスケールアウト用エンドポイントの既定無効化やGPTQ g_idx の削除といった破壊的変更があり、更新前に設定の確認が要ります。
【用語解説】
- テンソル並列: 1つのモデルを複数のGPUに分割して同時に計算させる方式。1枚のGPUに載りきらない大きなモデルを動かすために使う
- 投機的デコード: 小さく速いモデルに先に答えの候補を書かせ、本命のモデルがまとめて正誤を確認する高速化の手法
- KVキャッシュ: 生成の途中経過を保存しておく領域。これがGPUメモリを圧迫すると、同時に捌ける会話の数が減る
引用元:
- [1] vLLM v0.30.0 リリースノート(GitHub)
- [2] vLLM 公式ドキュメント(vLLM)
- [3] vLLM リポジトリ(GitHub)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
GitHub Copilotのエージェントの動きを監視ツールで追えるように。既定でプロンプト除外


Next Post
生成AIニュース 昨日【2026年9月23日(水)】のAI公式発表を3分でチェック

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。