


📖 この記事で分かること
- FlashProve が証明できることと、公開された範囲
- 証明にかかる GPU 時間と、必要な GPU の条件
- 研究プロトタイプとして評価するときの注意点
- 本番導入より要件整理に向くと見る理由
💡 知っておきたい用語
- ゼロ知識証明:金庫の中身を見せずに「開け方を知っている」ことだけを示すように、情報を明かさず主張の正しさを示す暗号技術
- MoE【エムオーイー】:受付が質問ごとに担当者を振り分けるように、入力に応じてモデル内の一部だけを動かす構造
最終更新日: 2026年11月4日
▶ 公式ページ
- FlashProve のコードと文書(GitHub)
- FlashProve の研究発表ページ(Anthropic)
FlashProve は何を証明するのか
この記事のポイント
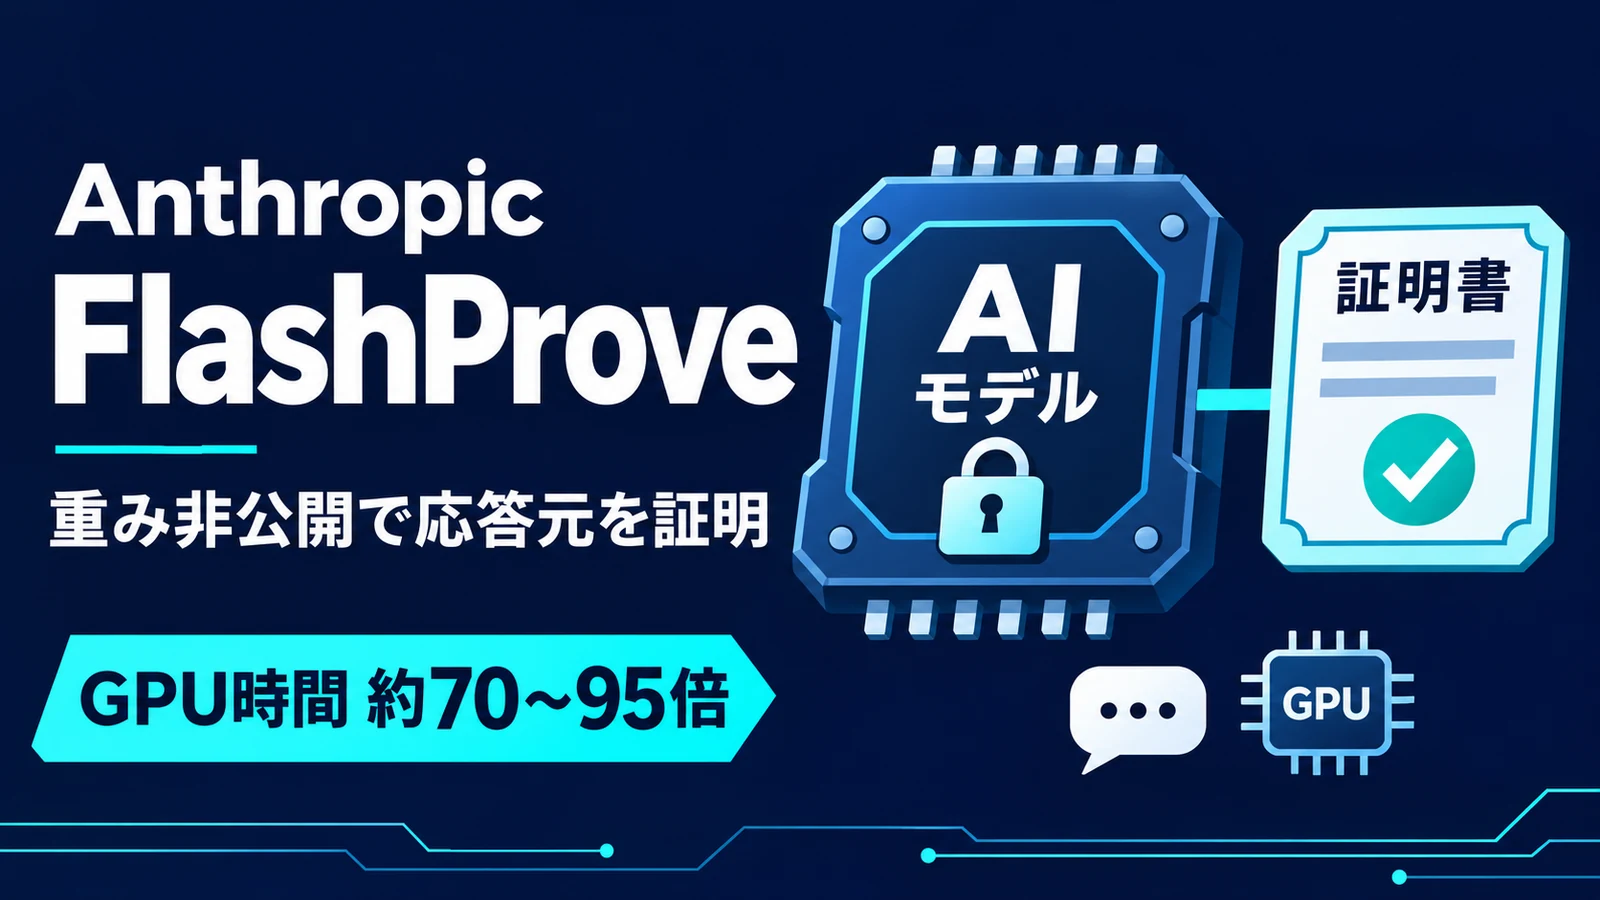
- Anthropic が 2026 年 11 月 2 日、FlashProve を Apache 2.0 で公開しました(2026年11月時点)。
- 証明生成の GPU 時間は、vLLM 実行の約 70〜95 倍です(2026年11月時点)。
- 証明器には専有の H100 80GB が 1 枚必要で、メンテナンスはされません。
変わるのは、「どのモデルが答えたか」を提供者の説明だけに頼らず、重みを公開しないまま暗号学的な証明で示す方式を、開発者が公開コードで評価できるようになった点です。API でモデルを提供する側も利用する側も、証明にかかる GPU 費用と検証の要件を実物で見積もれます。ただし、公開されたのは本番向けの製品ではなく、メンテナンスされない研究プロトタイプです。
FlashProve は、大規模な MoE(入力ごとにモデル内の一部だけを動かす構造)言語モデルの推論を証明可能にするシステムです。GitHub の説明によると、AI 提供者はモデルの重みを明かさずに、どのモデルがリクエストに応答したかを証明できます。同リポジトリは、FlashProve を AI 推論のゼロ知識証明(中身を明かさず、主張の正しさだけを示す暗号技術)の研究プロトタイプと位置づけています。
公開された仕様と動作条件
大規模モデルをフルサイズのまま GPU 1 枚で扱える一方、証明には通常の推論より桁違いの GPU 時間がかかります。Anthropic の発表とリポジトリから、評価に関わる条件は次のとおりです。
- 動作条件: Llama 4 Maverick(2026年11月時点)をフルサイズ、1,024 トークンのコンテキスト(2026年11月時点)で、NVIDIA H100 1 枚上で動かす
- 証明のコスト: 証明生成の GPU 時間は、vLLM(広く使われるオープンソースのライブラリ)で同じモデルを動かす場合の約 70〜95 倍
- 証明器の要件: 証明器(prover、証明を生成するプログラム)の実行には、ほかの処理に使わない NVIDIA H100 80GB が 1 枚必要
- 公開物: コード、Lean(数学の証明を機械で検査する言語)の証明、文書を Apache 2.0 ライセンスで公開
- 保守: 研究プロトタイプで、リポジトリには「Not maintained」と記載
Anthropic は今後の作業として、アーキテクチャの詳細も隠すことを「plan」としています。
開発者の評価で見るところ
最初に確かめるのは、証明したい応答の量と GPU 予算が釣り合うかです。たとえば、外部提供者のモデルを社内の問い合わせ回答システムに組み込み、監査向けに「契約したモデルが応答した」証拠を残したいチームを考えます。
vLLM で 1 GPU 時間かかる処理なら、単純計算で証明には約 70〜95 GPU 時間が必要です。証明器の H100 は専有が条件なので、推論基盤の空き GPU に相乗りさせる見積もりは成り立ちません。
モデルを提供する側の基盤担当者は、次の 3 点を文書と照らして確認すると、評価を続けるかどうかを判断しやすくなります。
- 入力の長さ: 公開された動作条件は 1,024 トークンのコンテキストです。これを超える入力を扱う処理では、条件をそのまま比較に使えません。
- 隠したい情報の範囲: アーキテクチャの秘匿は今後の作業とされています。重み以外に秘匿したい情報があるなら、現行の扱いを確認する必要があります。
- 保守の負担: メンテナンスされないため、コードを取り込むなら修正や更新を自社で引き受ける前提になります。
編集部の見方
編集部は、FlashProve を本番導入の候補ではなく、「応答元のモデルをどう検証するか」という要件を詰めるための参照実装として評価するのがよいと見ています。
- 根拠 1: 研究プロトタイプで、メンテナンスされないと明記されています。長期運用する基盤の依存先には置きにくい条件です。
- 根拠 2: 証明の GPU 時間は約 70〜95 倍で、専有の H100 も必要です。すべての応答に証明を付ける前提では費用が重く、仮に評価するなら監査対象の応答に絞った見積もりが現実的です。
- 根拠 3: それでも、Llama 4 Maverick をフルサイズのまま H100 1 枚で動かす実装と Lean の証明が、Apache 2.0 で公開されています。自社の要件と照らして検討できる材料がそろっている点に価値があります。
この見方が変わるのは、保守される実装が登場し、GPU 時間の倍率が監査予算に収まる水準まで下がった場合です。そのときは、参照実装ではなく導入候補として比較する段階に移ります。
よくある質問
Q: 商用サービスに組み込めますか?
A: コード、Lean の証明、文書のライセンスは Apache 2.0 です。実務上の判断点はライセンスより保守で、メンテナンスされないコードを自社で支えられるかを先に確認する必要があります。
Q: 回答の内容が正しいことも証明されますか?
A: 公開資料で説明されている対象は、どのモデルが応答したかの証明です。回答が事実として正しいかどうかは、別に確かめる必要があります。
Q: H100 以外の GPU でも動きますか?
A: 今回確認した資料で示されている証明器の要件は、専有の NVIDIA H100 80GB 1 枚です。ほかの GPU を検討する場合は、リポジトリの文書で条件を確認してください。
まとめ
FlashProve は、重みを明かさずに応答元のモデルを証明する仕組みを、コードと Lean の証明つきで公開した研究プロトタイプです。フルサイズの Llama 4 Maverick を H100 1 枚で扱える一方、GPU 時間は約 70〜95 倍かかり、メンテナンスもされません。検証の要件を整理する材料として読み、導入の判断は費用と保守の条件を確かめてから行うのが堅実です。
【用語解説】
- vLLM: 言語モデルの実行に使われるオープンソースのライブラリ。Anthropic は、FlashProve の GPU 時間を比べる基準に用いています。
- Lean: 数学の証明を記述し、機械で検査できる言語。FlashProve では、コードとあわせて Lean の証明が公開されています。
- 証明器(prover): 主張が正しいことを示す証明を生成するプログラム。FlashProve では、専有の H100 80GB 上で実行します。
引用元:
- [1] FlashProve の研究発表ページ(Anthropic)
- [2] anthropics/FlashProve(GitHub)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
Stability AIのStable Audioで曲の一部を差し替え可能に。短いサンプル集も作れる


Next Post
Gemini 2.5 Pro/FlashのAPIが12月1日から振り替え。モデル文字列の更新が必要

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。