
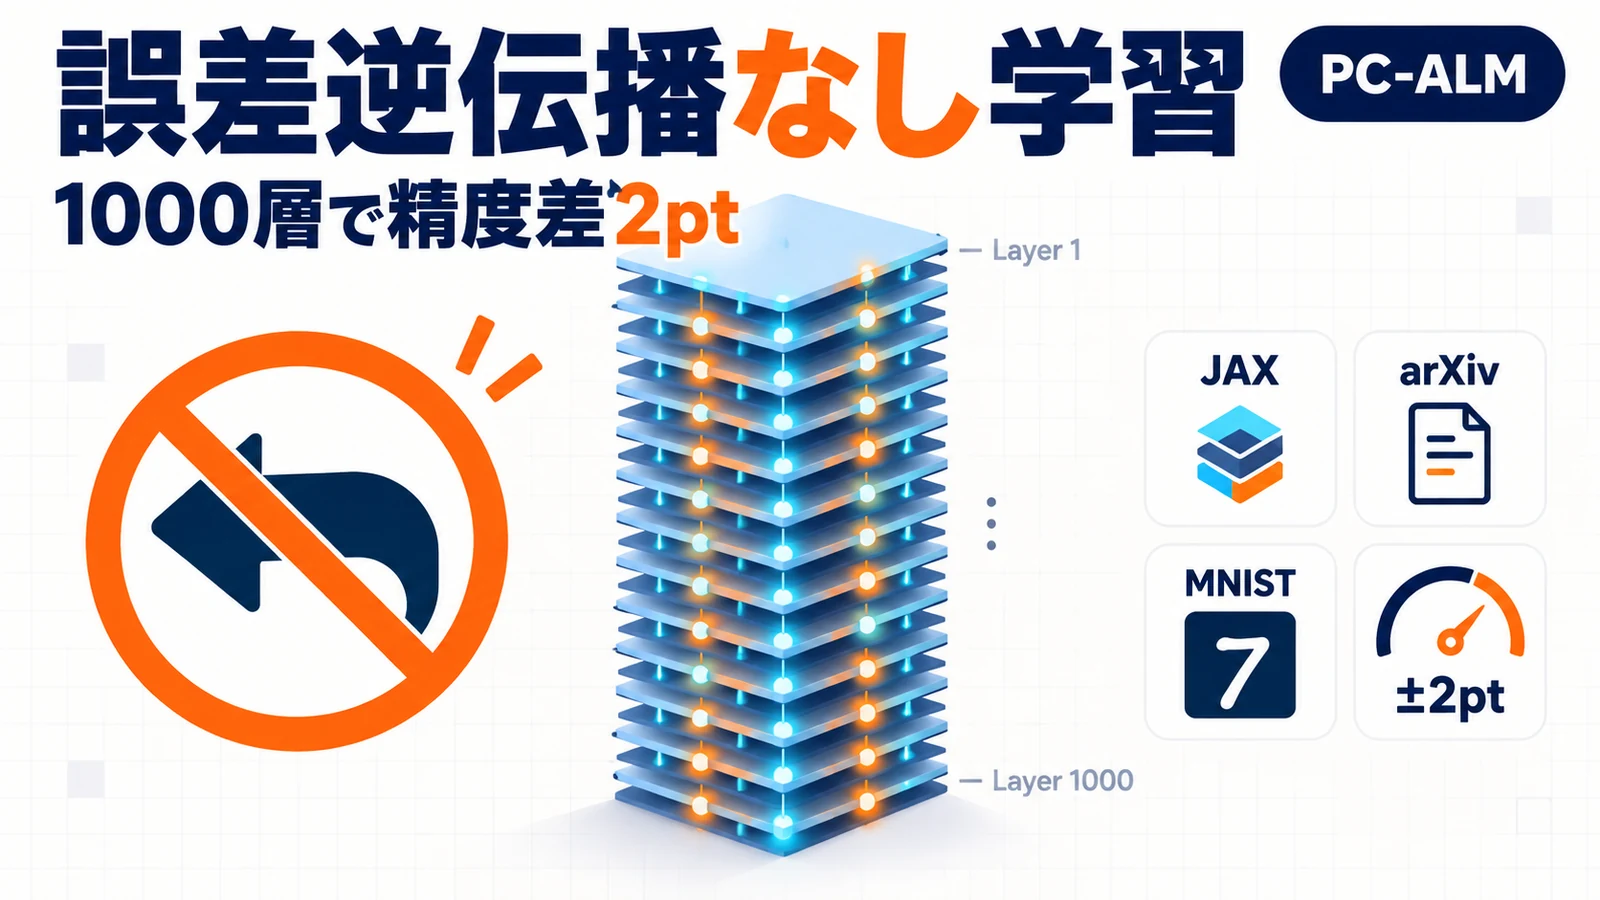


Sakana AI PC-ALM(Augmented Lagrangian Predictive Coding)は、誤差逆伝播を使わずに各層が隣接層とだけ通信する局所計算で深いネットワークを学習する手法で、1000層の残差MLPをMNISTで学習し誤差逆伝播との精度差を約2ポイント以内に抑えました。
📖 この記事で分かること
- Sakana AIが公開したPC-ALMの概要と一次ソース
- 層ごとの局所計算だけで1000層を学習した結果
- 従来の予測符号化と比べて何が変わったか
- 論文・JAX実装コードの入手先と現時点の限界
💡 知っておきたい用語
- 誤差逆伝播(バックプロパゲーション):出力の間違いを出口から入口へ順に配り直す、現在のAI学習の標準手順。工場でいえば「最終検品の結果を全工程へ逆順に通達する」やり方
- 予測符号化(PC):各層が隣の層とだけやり取りし、予測のずれを直していく学習法。全体への一斉通達を使わない
最終更新日: 2026年9月15日
▶ 公式ページ
- PC-ALM 解説ページ(動く図付き)(Sakana AI)
- 公式 JAX 実装コード(GitHub)
PC-ALMとは何か
この記事のポイント
- Sakana AIが2026年9月、誤差逆伝播を使わない学習法「PC-ALM」の解説ページと公式コードを公開しました(2026年9月時点)。
- 1000層の残差MLPをMNISTで学習し、誤差逆伝播との精度差は全深さで約2ポイント以内です(2026年9月時点)。
- 論文はarXiv(2026年5月29日投稿)、実装はJAXで、MNIST/Fashion-MNISTの再現実験が手元で回せます。
Sakana AIの研究者Jeffrey Seely氏とJulian Gould氏は、誤差逆伝播(BP)を使わずに深いネットワークを学習する手法「PC-ALM(Augmented Lagrangian Predictive Coding)」を公開しました。各層が隣接層とだけ通信する「層ローカル」な計算のみで、1000層のネットワークを学習できたと報告しています。公式解説ページはpub.sakana.aiに置かれ、論文はarXiv、コードはGitHubで公開されています。
PC-ALMは、予測符号化(PC)と呼ばれる既存の局所学習法の拡張です。標準的なPCは深く幅の狭いネットワークで学習信号が途中で減衰する「信号減衰」の問題を抱えていました。PC-ALMは各層に「双対ニューロン」(ラグランジュ乗数)を1組ずつ追加し、層内の再帰計算をPI制御器として動かすことで、この減衰を抑えます。
公開された結果と数値
主要な結果は「1000層でも誤差逆伝播にほぼ並ぶ」という1点に集約されます。公式ページによると、幅32・ReLUの残差MLPをMNISTで5エポック学習した実験で、PC-ALMは10層から1000層までの全範囲で誤差逆伝播との精度差が約2ポイント以内でした。従来のPCは深さが増すと精度が急落しています。
論文側では、非線形ネットワークで深さ128までを解析し、幅と深さの全組み合わせで誤差逆伝播と同等の性能を示したとしています。線形ネットワークに限れば、局所更新だけで誤差逆伝播と厳密に同じ勾配に収束することも示されました。画像分類では、ResNet-18を使ったCIFAR-10とTiny ImageNetを含む全タスクで、従来のPCより精度が改善しています。
学習信号の伝わり方にも違いがあります。従来のPCでは信号が熱の拡散のようにゆっくり広がるのに対し、PC-ALMでは信号が一定の速さで入口側へ進み、各層に均等に配られます。公式ページはこれを「弾道的(ballistic)」な伝播と呼び、動く図で示しています。
何が変わり、どこまで使えるのか
現時点で実務のモデル学習に置き換わるものではなく、「局所計算だけで深いネットワークを学習できる」ことを示した研究段階の成果です。実験はMNISTやCIFAR-10など小規模なタスクと残差MLP中心で、公式ページも「より大きなネットワークと難しいタスクへの拡張」を今後の課題に挙げています。時系列タスクや自己教師あり学習への対応も未着手です。
一方で、この方向性が意味を持つ場面は明確です。誤差逆伝播は「順伝播→逆伝播→重み更新」の3段階を厳密な順序で回す必要があり、脳がそのまま実装できない理由の1つとされています。層ごとに独立して動く学習法は、力学系のシミュレーションがGPUより安いニューロモルフィック(脳型)ハードウェアでの省エネ学習につながる可能性があると公式ページは述べています。
再現環境は整っています。GitHubの公式実装はJAX製で、MNISTとFashion-MNISTにおける残差MLPの幅・深さグリッドを対象に、誤差逆伝播・PC・PC-ALMを同じアーキテクチャで比較できます(2026年9月時点)。
編集部の見方
編集部は、PC-ALMの本命は「今のGPU学習を置き換える」ことではなく、脳型ハードウェア向け学習法の候補として初めて実用的な深さに届いた点にあると見ます。
- 根拠1: 公式ページは「層ローカルな手法で1000層を学習できた例は自分たちの知る限り初めて」と明記しており、従来のPCで報告されていた128層程度の深さを大きく超えています。
- 根拠2: 動機として掲げられているのは神経科学とニューロモルフィック計算であり、ベンチマーク上の最高精度更新ではありません。実験も残差MLPと小規模データに絞られています。
- 根拠3: 論文投稿は5月29日で、解説ページと公式コードの整備が9月に揃いました。研究コミュニティが追試できる形まで出し切っている点は、日本発のAI研究として評価できます。
- この見方が変わる条件: PC-ALMが言語モデル級のTransformerや大規模データで誤差逆伝播に並ぶ結果を示した場合、位置づけは「脳型ハードウェア向け」から「学習アルゴリズムの選択肢」へ移ります。
よくある質問
Q: PC-ALMはすぐに自分のモデル学習に使えますか?
A: 公式のJAX実装はMNIST/Fashion-MNISTの残差MLPを対象にした参照実装です。汎用フレームワークへの組み込みは提供されておらず、研究用途の再現が主な使い道です(2026年9月時点)。
Q: 誤差逆伝播より精度が高いのですか?
A: いいえ。公式ページの数値では誤差逆伝播に「ほぼ並ぶ」水準で、1000層のMNISTで約2ポイント以内の差です。優位性は精度ではなく、全体を同期させる逆伝播なしで学習できる点にあります。
Q: 論文とコードはどこで読めますか?
A: 論文はarXiv(2605.31022)、コードはGitHubのSakanaAI/pc-almリポジトリ、解説と動く図はpub.sakana.aiで公開されています。
まとめ
Sakana AIは誤差逆伝播を使わない層ローカルな学習法PC-ALMを公開し、1000層の残差MLPをMNISTで誤差逆伝播との差約2ポイント以内で学習できたと報告しました。従来の予測符号化が抱えていた信号減衰を、各層のラグランジュ乗数による制御で抑えたのが要点です。対象はまだ小規模タスクに限られ、大規模モデルへの拡張は今後の課題として残されています。
【用語解説】
- ラグランジュ乗数【らぐらんじゅじょうすう】: 「守るべき条件」からのずれを数値として持ち続け、最適化に反映させる補助変数。PC-ALMでは各層の制約違反を蓄積する役目を担う
- 残差MLP: 層の入力をそのまま出力に足す「スキップ接続」を持つ多層パーセプトロン。深くしても学習が崩れにくい構造
- ニューロモルフィック(脳型)ハードウェア: 脳の神経回路を模した計算装置。力学系の計算が得意で、GPUより低い消費電力を狙う
引用元:
- [1] Augmented Lagrangian Predictive Coding: Training 1000-layer networks without backpropagation(Sakana AI)
- [2] Augmented Lagrangian Predictive Coding (arXiv:2605.31022)(arXiv)
- [3] SakanaAI/pc-alm — Official JAX reference implementation(GitHub)
- [4] Sakana AI Researchers Introduce PC-ALM, a Layer-Local Alternative to Backpropagation That Trains 1000-Layer Networks(MarkTechPost)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
Claudeに金融アドバイザー向け版。Schwabなど11社のデータをつなぎ面談準備を任せられる


Next Post
ChatGPTのPlus・Pro、質問に応じて自動で考え込む機能を終了。深く考えさせるには自分で選ぶ

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。