

📖 この記事で分かること
- NVIDIAが公開した小型オープンモデルの概要
- 前モデル比・同クラス比で公式が示した数値
- 35言語対応や64Kトークンなどの仕様と条件
- 評価前に確認すべきライセンスと推論予算の注意点
💡 知っておきたい用語
- 推論の予算制御: モデルが答えを出す前に「考える」ために使ってよいトークン量に上限をかける仕組み。財布に入れる額を先に決めておくイメージ
最終更新日: 2026年10月25日
▶ 公式ページ
- Nemotron 3.5 Bolt E4B 4GB 公式ページ(NVIDIA Research)
- NVIDIA-Nemotron-3.5-Bolt-E4B-4GB モデルカード(Hugging Face)
Nemotron 3.5 Bolt E4B の概要
この記事のポイント
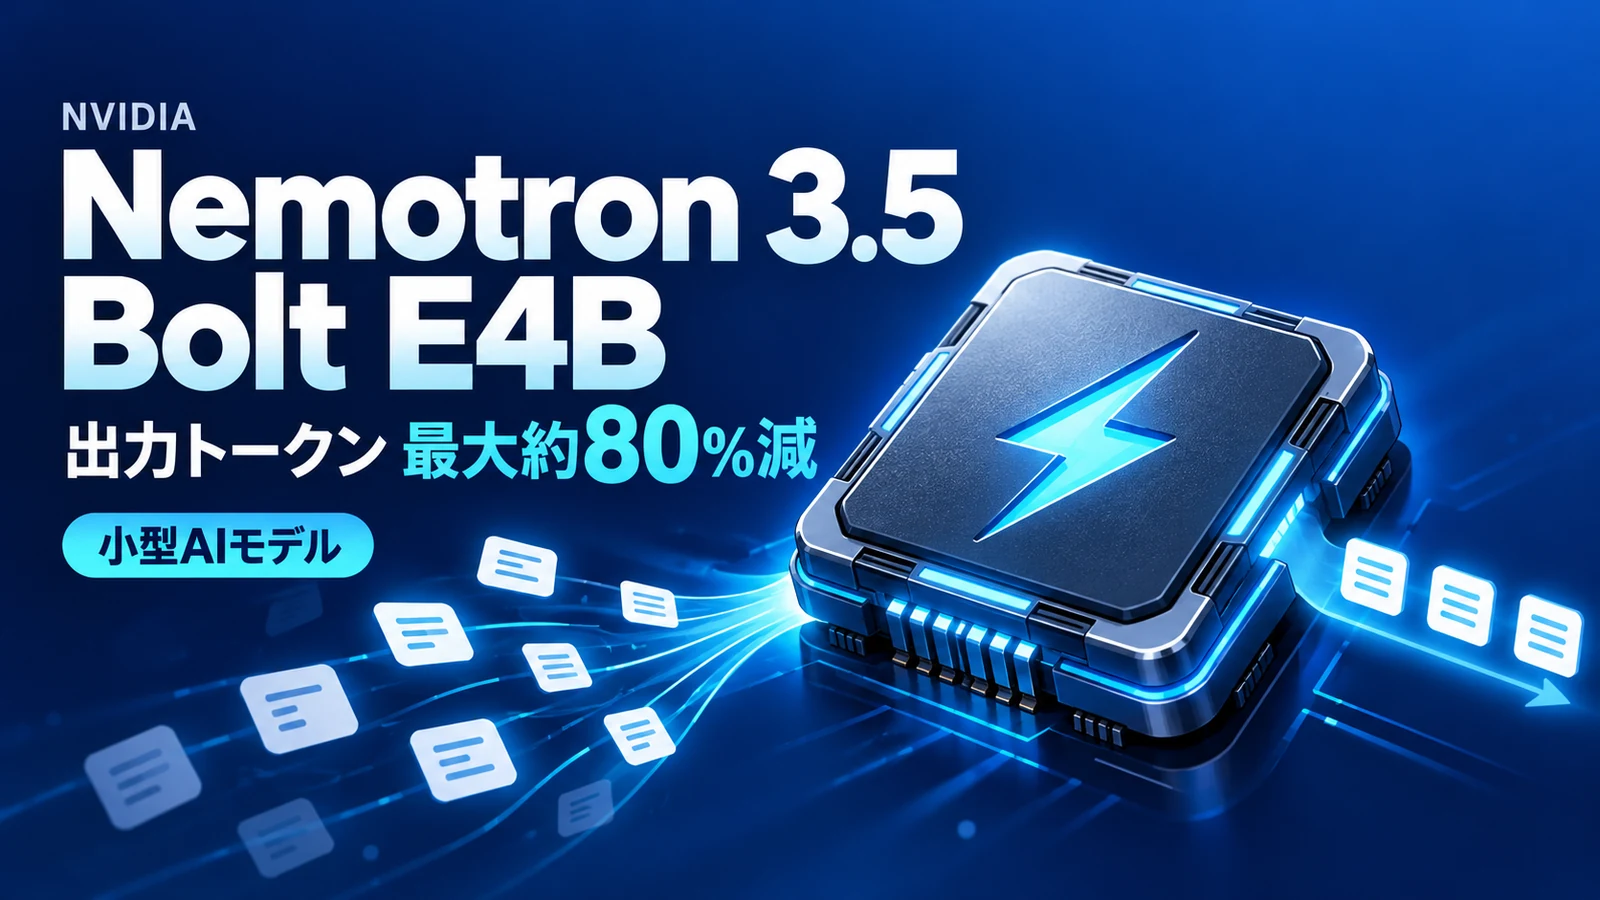
- NVIDIAが2026年10月23日、小型オープンモデル「Nemotron 3.5 Bolt E4B 4GB」を公開(2026年10月時点)。
- 前モデル比で平均約40%の品質向上、同クラス比で出力トークン最大約80%減と説明。
- Hugging Face・Ollama・LM Studioなどで入手でき、利用条件はOpenMDW License 1.1版。
ローカルで会話エージェントを組んでいる開発者にとっての変化は、「短い出力で、何ターンもツールを呼び続ける」ことを狙った小型オープンモデルが、Ollama や LM Studio など手元の既存ランタイムからすぐ評価できる形で出たことです。応答の待ち時間を詰めたい音声アシスタントや組み込み UI では、今使っている小型モデルと出力の長さ・ツール呼び出しの精度を並べて比べる候補になります。モデルは NVIDIA が2026年10月23日に公開した「Nemotron 3.5 Bolt E4B 4GB」(2026年10月時点)です。
NVIDIAは本モデルを会話エージェント向けの小型オープン言語モデルと位置づけ、モデルカードでは用途として「ローカルで速く動く音声・端末アシスタント、対話キャラクター、組み込みインターフェース」を挙げています。あわせて、複数ターンにわたるツール利用(関数呼び出しを会話の中で繰り返すこと)に重点を置いたとしています。
公式が示した性能と仕様
数値はいずれもNVIDIAの説明によるもので、比較の対象と条件は公式の書き方どおりに読む必要があります。
- 品質: 会話エージェントの主要ベンチマークで、NVIDIAの前のモデルより平均約40%高い品質になったとしています。比較対象は公式ページで「our prior model」と書かれています
- 出力の短さ: 同じクラスのモデル(公式ページの表現は「peers」)と比べ、出力トークン数が最大約80%少ないとしています。比較したモデル名は、この記事の材料では確認していません
- 言語: 35言語に対応し、ベースモデルは140以上の言語で事前学習されています
- コンテキスト長: 最大64Kトークン(2026年10月時点)
- ライセンス: OpenMDW License Agreement 1.1版(2026年10月時点)が適用されます。モデルカードがこのモデルの利用条件として指定している契約で、利用できる範囲はこの条文で決まります
入手先として公式ページは、Hugging Face、Ollama、LM Studio、Unsloth、Canonical、Jetson AI Lab、NVIDIA In-Game Inferencing SDK【エスディーケー】を挙げており、いずれも「today」から使い始められると案内しています。
評価・導入で見るべき点
小型モデルを会話エージェントに組み込むとき、判断材料になるのは「品質」「応答の長さ」「ライセンス」「推論予算を絞ったときの挙動」の4点です。
たとえば、端末上の音声アシスタントでは、モデルが返すトークンが少ないほど生成と読み上げにかかる時間が短くなります。NVIDIAが挙げる「出力トークン最大約80%減」は、この種の用途の応答時間に直接関わる数字です。ただし「最大」の値であり、手元のプロンプトやタスクで同じ幅になるとは限りません。自分のツール呼び出しシナリオで、既存モデルと出力長・正答率を並べて測るのが確実です。
気をつける点は2つあります。1つ目はライセンスです。OpenMDW License Agreement 1.1版が適用されるため、商用の組み込み製品に載せる場合は条文を自社の利用形態と照らし合わせる必要があります。2つ目は推論の予算制御(回答前の思考に使うトークン量の上限を指定する仕組み)です。モデルカードには、トークン割り当てを絞ると思考の過程(最終回答の前にモデルが生成する推論部分)が文の途中で切れることがあると書かれています。応答時間を詰めるために予算を下げる設計では、切れた状態でツール呼び出しや最終回答が崩れないかを評価項目に入れておくべきです。
対応ハードウェアや必要メモリの要件はこの記事の材料に含めていないため、導入前に公式ページとモデルカードで確認してください。
編集部の見方
編集部は、このモデルの評価軸として最初に見るべきは「約40%の品質向上」より 「出力トークン最大約80%減」 だと考えます。
- 根拠1: NVIDIAが挙げる主用途は、ローカルの音声・端末アシスタントと組み込みインターフェースです。こうした用途では、出力の短さが応答の待ち時間に直結します。
- 根拠2: 品質の約40%向上は「前のモデル」との比較で、他社の同クラスモデルとの比較ではありません。一方、出力トークンの削減は「同クラス比」として示されており、乗り換え判断に使いやすい比較軸です。
- 根拠3: 複数ターンのツール利用に重点を置いたとされており、短い出力でツールを繰り返し呼ぶ設計と相性が合います。ただし推論予算を絞ると思考が途中で切れる場合がある、という制約も同じモデルカードに書かれています。
この見方が変わる条件は、手元の評価で予算を絞ったときにツール呼び出しの精度が大きく落ちる場合です。その場合、出力の短さは予算を緩めた設定でしか得られず、応答時間の利点は小さくなります。
よくある質問
Q: どこで入手できますか?
A: 公式ページは、Hugging Face、Ollama、LM Studio、Unsloth、Canonical、Jetson AI Lab、NVIDIA In-Game Inferencing SDKを入手先として挙げています。
Q: 日本語に対応していますか?
A: 公式ページは35言語対応、ベースモデルは140以上の言語で事前学習としています。日本語が35言語に含まれるかは、この記事の材料では確認できていないため、モデルカードの言語一覧で確認してください。
Q: 商用利用できますか?
A: 利用にはOpenMDW License Agreement 1.1版が適用されます。商用での可否や条件は、このライセンスの条文で判断する必要があります。
まとめ
NVIDIAは2026年10月23日、会話エージェント向けの小型オープンモデル「Nemotron 3.5 Bolt E4B 4GB」を公開しました。前モデル比で平均約40%の品質向上、同クラス比で出力トークン最大約80%減と説明しており、35言語対応・最大64Kトークンです。評価にあたっては、OpenMDW License 1.1版の条件と、推論予算を絞ったときに思考が途中で切れうる点を確認項目に含める必要があります。
【用語解説】
- オープンモデル: 重み(学習済みのパラメータ)が公開され、利用者が自分の環境で動かせるモデル。利用条件はモデルごとのライセンスで決まる
- コンテキスト長: モデルが1回の処理で読める入力と出力の合計の長さ。トークン数で表す
- ツール利用: モデルが外部の関数やAPIを呼び出し、その結果を使って応答を組み立てること
引用元:
- [1] Nemotron 3.5 Bolt E4B 4GB(NVIDIA Research)
- [2] NVIDIA-Nemotron-3.5-Bolt-E4B-4GB(Hugging Face)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。


15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。