

📖 この記事で分かること
- Voxtral 3 と音声エージェントSDKの中身
- リアルタイム文字起こしの遅延と対応言語数
- Mini版の規模と1分あたりの料金
- 導入前に確かめておきたい条件
💡 知っておきたい用語
- 話者分離:会議の録音で「誰がどこを話したか」を分けて書き起こす機能。複数人の通話記録を後から読むときに効きます
最終更新日: 2026年10月21日
▶ 公式ページ
- Voxtral 3 発表ページ(Mistral AI)
Voxtral 3 の概要
この記事のポイント
- Mistral AI が2026年10月20日、音声モデル群 Voxtral 3(2026年10月時点)を発表し、Mistral API で提供を開始しました。
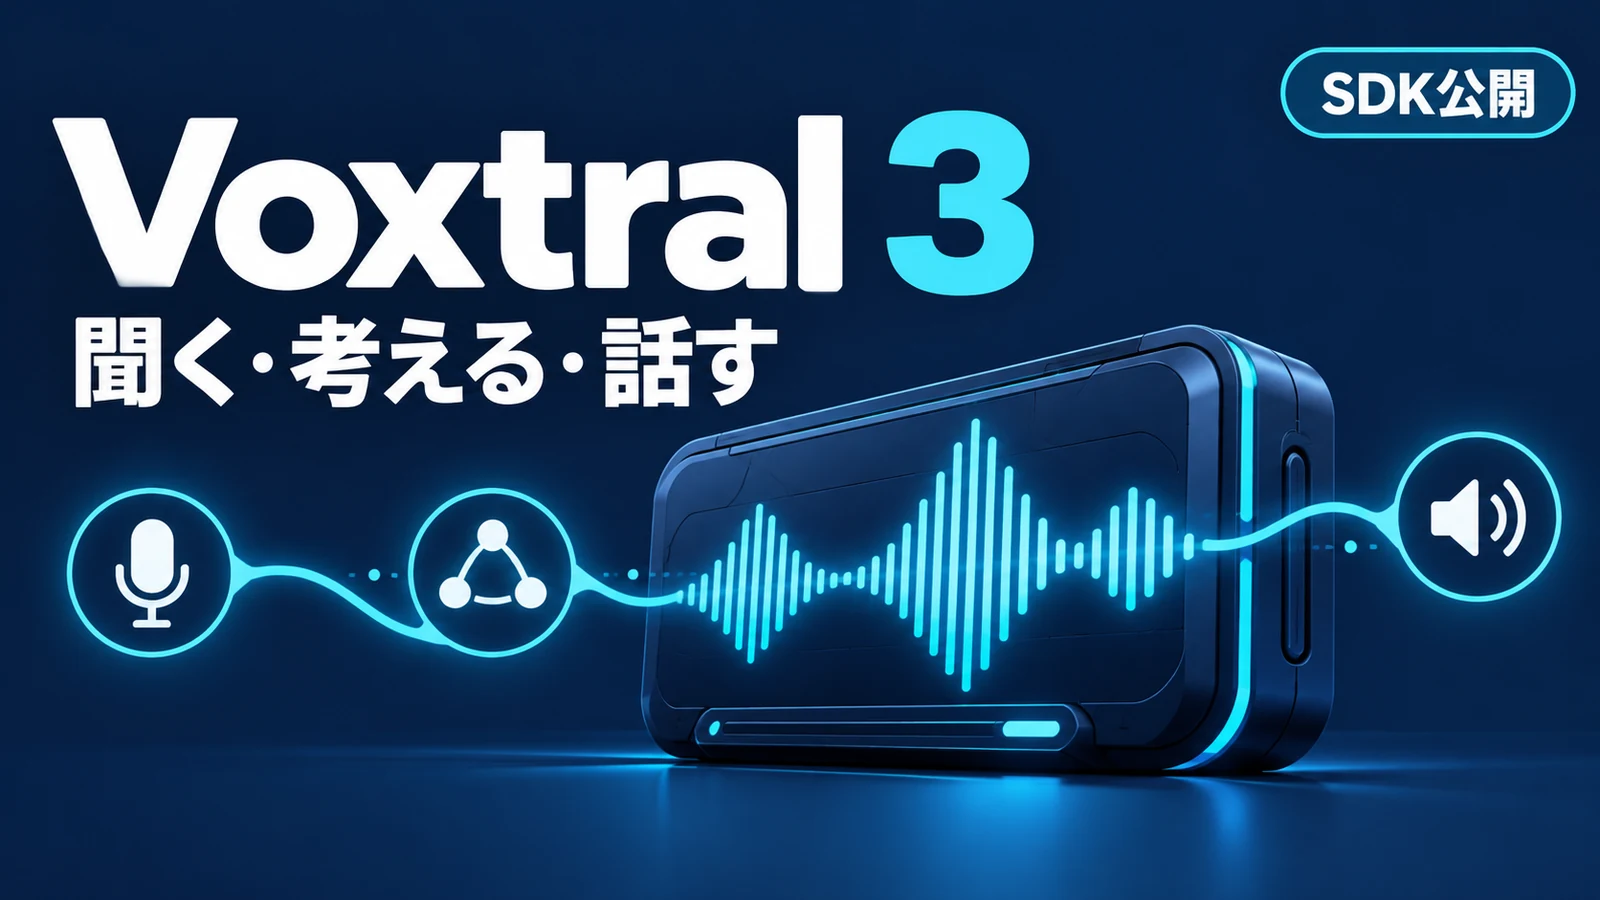
- 聞き取り・推論・発話を1本のストリーミング処理で動かす音声エージェントSDKを同時公開。
- 文字起こし Mini 版は4Bパラメータ、1分0.0035ドル(2026年10月時点)。
音声ボットを作る開発者にとって、文字起こし・応答生成・音声合成を別々につなぎ合わせていた部分を、1つのSDKでまとめて扱える選択肢が増えました。Mistral AI が2026年10月20日に発表した Voxtral 3 は、音声認識(文字起こし)と音声合成のモデル群に、音声エージェント向けのSDK【エスディーケー】を加えたものです。発表日から Mistral API【エーピーアイ】で使え、欧州・米国・グローバルの各エンドポイントで提供されています。
SDKとモデルの仕様
今回の中心は、音声の入力から推論、音声の出力までを1本のストリーミング処理として動かす音声エージェントSDKです。Mistral の発表によると、このSDKは LiveKit(リアルタイムの音声・映像通信を扱うオープンソース基盤)の上に作られています。発表の冒頭では、聞き取り・推論・ツール呼び出し・発話を1本の流れにまとめるものと説明されています。
モデル側で数字が示されているのは、次の3点です。
- リアルタイム文字起こし: 35以上の言語に対応し、遅延は500ミリ秒未満。話者分離と、コンテキストバイアス(製品名や人名など、あらかじめ渡した語を聞き取りやすくする機能)にも対応
- Mini 版(文字起こし): 4Bパラメータ、料金は1分あたり0.0035ドル(2026年10月時点)
- 会話全体: Mistral は Voxtral 3 を、50以上の言語での複数ステップのリアルタイム会話に向けて作ったとしています
技術者が見落としやすいのは、言語数が2種類出てくる点です。リアルタイム文字起こしの対応は「35以上」、会話用途としての対応は「50以上」と、発表文の中で別の数字が書かれています。リアルタイム文字起こしを前提に設計する場合は、前者の数字で考える必要があります。
影響と導入前に確かめること
影響が大きいのは、電話や音声窓口のように、相手の発話に即座に応える必要がある用途です。Mistral は用途として、コンタクトセンターのエージェント、サービスデスク、仮想アシスタント、ハンズフリーのコパイロットを挙げています。
たとえば問い合わせ窓口の音声ボットでは、相手の発話を文字にし、内容を判断して社内システムを照会し、答えを読み上げる、という一連の処理が要ります。これまでは各段を別の部品で組み、段の間の待ち時間を詰める作業が開発側に残っていました。Voxtral 3 のSDKは、この流れ全体を1本のストリーミング処理として扱う設計です。
評価を始める前に確かめておきたい条件は次のとおりです。
- 対応言語: 日本語の音声を扱う場合は、公式の対応言語の一覧に日本語が入っているかを確認する
- データの置き場所: エンドポイントは欧州・米国・グローバルの3種類。個人情報を含む通話を扱うなら、どこで処理されるかを要件と照らす
- 閉じた環境での運用: 一式をオンプレミスやプライベートクラウドで動かすには、Mistral の担当チームへの問い合わせが必要とされている
- 料金の比較: 本記事で確認できた料金は Mini 版の1分0.0035ドルです。他のモデルやSDK利用時の費用は、公式の料金表で確かめる必要があります
「500ミリ秒未満」は Mistral が示す文字起こしの遅延です。応答生成や音声合成を含めた会話全体の待ち時間とは別の数字なので、自社の音声データとネットワーク条件で測ってから判断するのが確実です。
編集部の見方
編集部は、Voxtral 3 で評価すべき中心はモデル単体の性能より、聞き取りから発話までを1本の流れにまとめたSDKの側だと見ています。
- 根拠1: SDKは音声入力・推論・音声出力を1本のストリーミング処理として動かし、LiveKit という既存のリアルタイム通信基盤の上に作られている。段ごとに部品をつなぐ構成と比べて、遅延を詰める作業の置き場所が変わる。
- 根拠2: リアルタイム文字起こしの遅延が500ミリ秒未満とされ、話者分離とコンテキストバイアスも同時に使える。窓口用途で必要になる「誰が言ったか」「固有名詞を取りこぼさないか」の両方に対応している。
- 根拠3: 提供先が欧州・米国・グローバルのエンドポイントに分かれ、オンプレミス運用にも相談の窓口がある。通話データの扱いに制約がある組織でも、検討の入口がある。
この見方が変わる条件は、対応言語です。リアルタイム文字起こしの「35以上」に日本語が含まれていなければ、日本語の窓口で使う価値は大きく下がり、評価はSDKの設計を参考にする段階にとどまります。
よくある質問
Q: Voxtral 3 はいつから使えますか?
A: Mistral によると、発表日の2026年10月20日から Mistral API で利用でき、欧州・米国・グローバルのエンドポイントで提供されています。
Q: 自社のサーバーやプライベートクラウドで動かせますか?
A: Mistral は、一式をオンプレミスやプライベートクラウドで動かす場合は担当チームに問い合わせるよう案内しています。API のように即日使える形ではありません。
Q: 対応言語の数が記事によって違うのはなぜですか?
A: 発表文の中で、リアルタイム文字起こしは35以上、会話用途は50以上と別の数字が示されているためです。どちらの機能を使うかで、見るべき数字が変わります。
まとめ
Mistral AI は2026年10月20日、音声モデル群 Voxtral 3 と、聞き取りから発話までを1本のストリーミング処理で動かす音声エージェントSDKを公開しました。リアルタイム文字起こしは500ミリ秒未満・35以上の言語、Mini 版は1分0.0035ドルです。日本語の窓口に使うかどうかは、対応言語とデータの処理場所を確かめてから判断することになります。
【用語解説】
- ストリーミング処理: 音声を最後まで受け取ってから処理するのではなく、届いた分から順に処理していく方式。応答までの待ち時間を短くできます
- LiveKit: リアルタイムの音声・映像通信を扱うためのオープンソース基盤。Voxtral 3 のSDKはこの上に作られています
- 4Bパラメータ: モデルの規模を表す数字で、約40億個の調整値を持つことを指します。数字が小さいほど軽く、動かす費用が下がる傾向があります
引用元:
- [1] Voxtral 3(Mistral AI)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
Geminiアプリに小規模事業者向けページ。Shopify・Xeroとつながる


Next Post
Android AutoのGeminiがGmailや予定を見て回答。仕事用アカウントは対象外

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。