
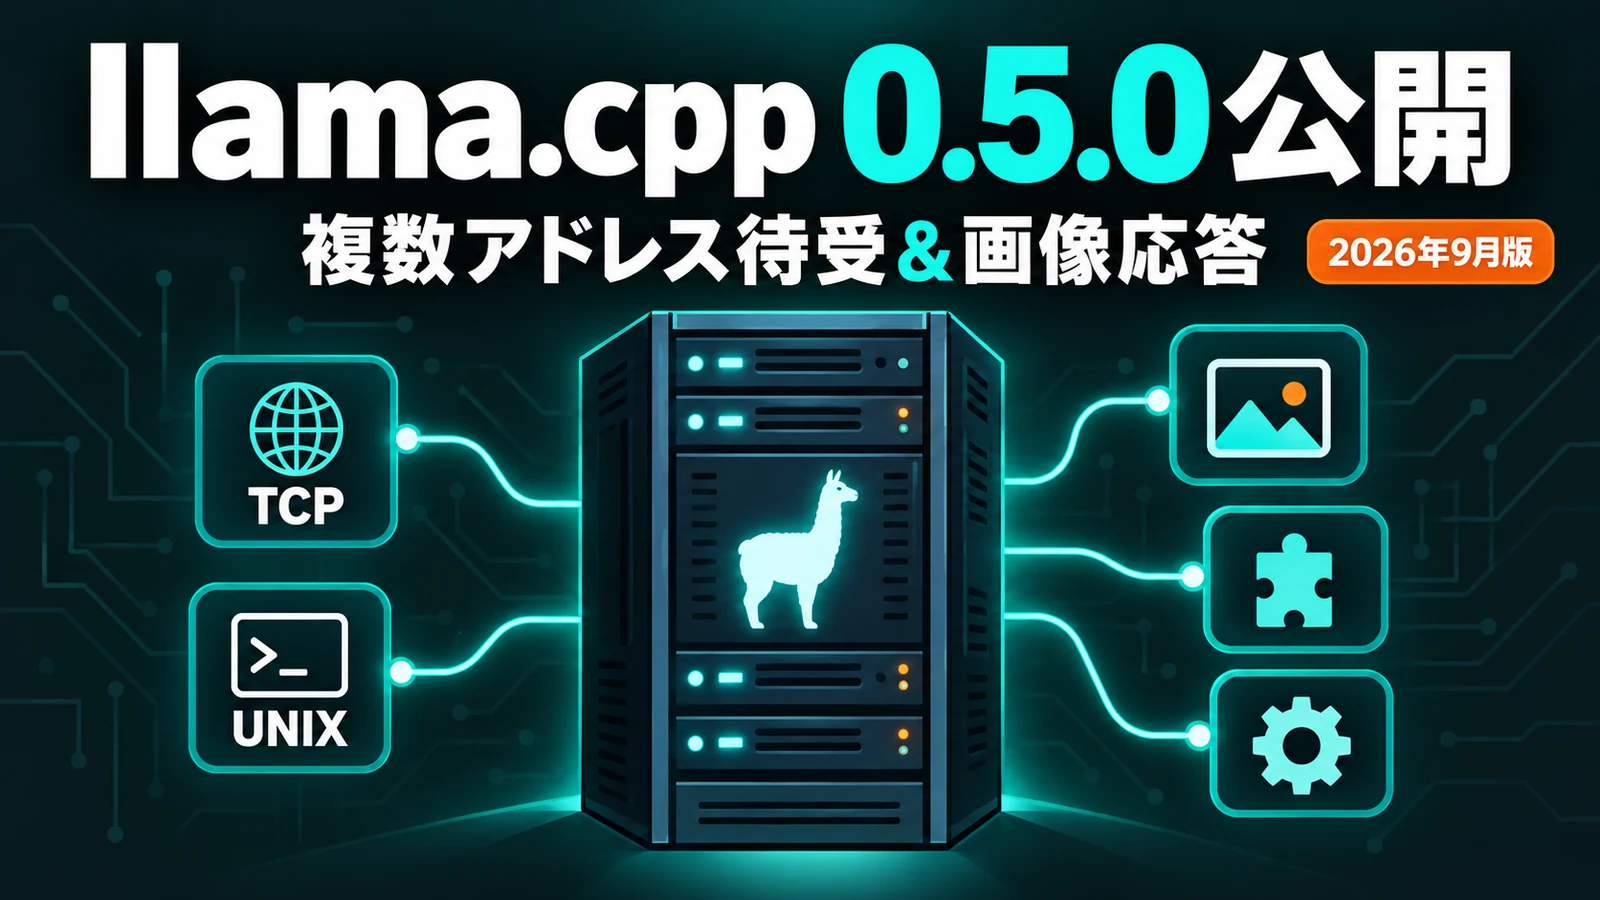


llama.cpp 0.5.0 は、ローカルLLM推論エンジン llama.cpp の新版で、2026年9月23日(米国時間)に GitHub で公開されました。
📖 この記事で分かること
- llama.cpp 0.5.0 で何が変わったか
- サーバ運用で効く変更点
- 新たに対応したモデルの範囲
- 更新前に確認しておきたい点
💡 知っておきたい用語
- ルーター:1つの窓口で複数のモデルを預かり、必要に応じて子プロセスとして起動・入れ替えする仕組み。受付係が担当者を呼び分けるイメージです
最終更新日: 2026年9月24日
▶ 公式ページ
- llama.cpp v0.5.0 リリースノート(GitHub)
- ggml v0.25.0 リリースノート(GitHub)
llama.cpp 0.5.0 の概要
この記事のポイント
- ggml-org が 2026年9月23日(米国時間)に llama.cpp v0.5.0(2026年9月時点)を公開しました。
- サーバが複数アドレスと UNIX ソケットで同時に待ち受け可能に。関数呼び出しの結果として画像も返せます。
- 内部の計算ライブラリ ggml が v0.25.0 になり、RPC プロトコルはメジャー v7 に上がりました。
ローカルで LLM【エルエルエム】を動かす推論エンジン llama.cpp の新版 v0.5.0 が、日本時間 9 月 24 日早朝に GitHub で公開されました。前版 v0.4.1 からの更新で、公式は重点を「バックエンドの性能と正確性」「対応モデルの拡大」「サーバ/ルーター運用の堅牢化」の 3 点としています。
サーバとAPIの変更点
運用面で最も効くのは、サーバの待ち受け先を複数指定できるようになった点です。--host にカンマ区切りで TCP アドレスや UNIX ソケットを並べられます(#28690)。ローカル向けのソケットと LAN 向けのアドレスを 1 プロセスで両立できます。
そのほかの主な変更は次のとおりです。
- サーバの関数呼び出し(function call)の出力で
input_image、つまり画像を返せるように - 開いているファイルから LoRA アダプタを読み込む
llama_adapter_lora_init_from_file_ptr()を追加 - temperature・top-p・min-p・ペナルティを環境変数で指定可能に
- ルーターのエビクション競合と子プロセスの寿命管理を修正
- ルーターが起動する子プロセスへ、ログファイルや API キーファイルを渡さないよう変更
最後の点は地味ですが、API キーを扱う構成では情報の渡り先が減る変更です。
性能と対応モデル
性能面では、CUDA の conv2d を implicit GEMM で高速化し、Apple シリコン向けの Metal では MoE と SSM_CONV の融合最適化が入りました。MTP(複数トークン予測)のドラフト処理では CUDA graphs が有効になっています。なお、どの程度速くなったかの数値は公式に記載がありません。
対応モデルでは、HRM-Text / DFM Mimir 1B への対応、MiMo-V2.6 の変換対応、HunyuanOCR の DFlash 対応、Nemotron 系の拡張、Qwen4Exp 向けの演算追加などが並びます。DeepSeek V3.2/V4、qwen3-coder、Gemma 4 などのチャット出力パーサの修正も含まれ、ツール呼び出しで出力が崩れていた人は更新で解消する可能性があります。Web UI は WEBM 動画を受け付けるようになりました。
編集部の見方
運用の地味な改善が中心: 新モデル対応より、複数アドレスでの待ち受けやルーターの競合修正のような「常駐させる人向け」の変更が目立ちます。社内や自宅でサーバとして動かし続けている利用者ほど恩恵が大きい版です。
エージェント用途への一歩: 関数呼び出しの結果で画像を返せる変更は、画面キャプチャや図を扱うツールをローカル LLM に組み合わせる構成で意味を持ちます。クラウド API で当たり前になった形に、ローカル側が追いついてきた流れと見ています。
更新前の確認点: ggml の RPC プロトコルがメジャー v7 に上がりました。旧版との互換性について公式の明記はありませんが、複数マシンを RPC でつないで推論している場合は、全ノードをそろえて更新するのが安全です。
よくある質問
Q: どんな人が更新すべきですか?
A: llama.cpp をサーバとして常駐させている人、ルーター機能で複数モデルを切り替えている人、DeepSeek や Gemma 4 などでツール呼び出しの出力崩れに困っていた人に向く更新です。
Q: 速度はどれくらい上がりますか?
A: CUDA と Metal の最適化が入っていますが、具体的な改善幅は公式に記載がありません(2026年9月時点)。
Q: 以前の記事で紹介した 0.4.0 から大きく使い方は変わりますか?
A: 公式リリースノートに破壊的な使い方の変更は明記されていません。RPC で複数マシンを使う構成のみ、全ノードの版をそろえることを勧めます。
まとめ
llama.cpp v0.5.0 は、サーバの複数アドレス待ち受け、関数呼び出しでの画像出力、ルーターの安定化など、常駐運用に効く変更が中心の版です。対応モデルとチャット出力パーサの修正も広く入りました。RPC 構成で使っている場合は、ggml v0.25.0 のプロトコル更新に合わせて全ノードをそろえて更新してください。
【用語解説】
- LoRA【ローラ】: モデル本体を作り直さず、小さな追加部品だけで振る舞いを調整する手法
- MoE: 入力ごとに一部の「専門家」だけを動かして計算量を抑えるモデル構造
- RPC【アールピーシー】: 別のマシンの処理を手元から呼び出す仕組み。llama.cpp では複数マシンで推論を分担するのに使われます
引用元:
- [1] Release v0.5.0 · ggml-org/llama.cpp(GitHub)
- [2] Release v0.25.0 · ggml-org/ggml(GitHub)
- [3] server: Add support for binding to multiple addresses #28690(GitHub)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
GeminiにAdobeやAirtableなど14サービスが接続可能に。@メンションで呼び出せる


Next Post
OSSエージェントgoose 1.52公開。音声で話しかけて作業を任せられるように

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。