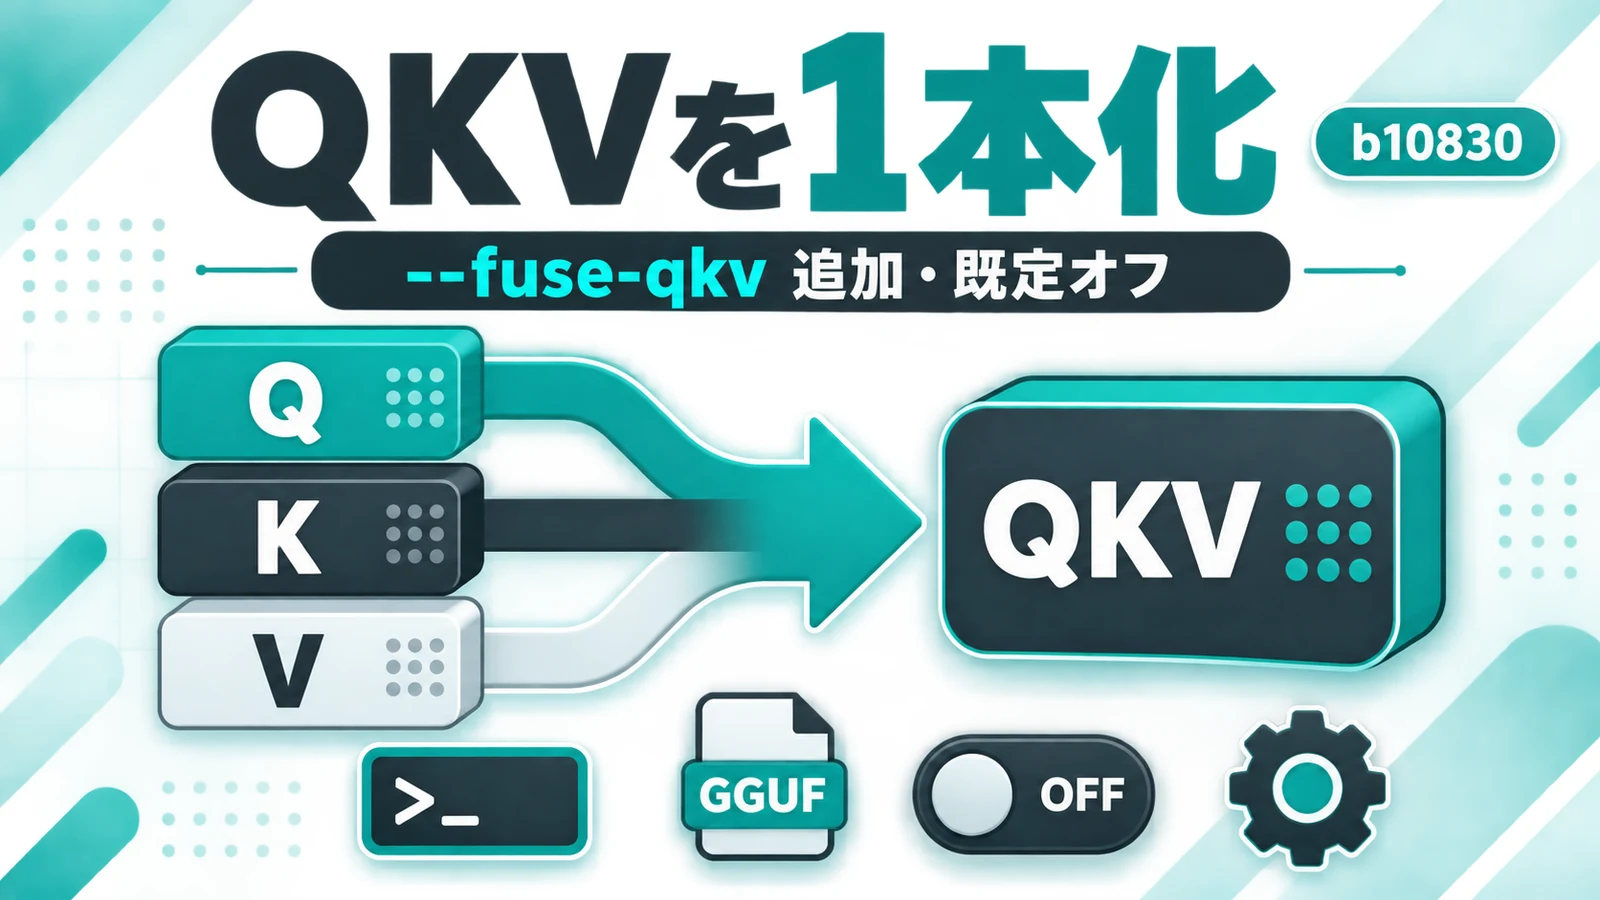


llama.cpp の fuse-qkv は、2026年9月6日公開のビルド b10830 で追加された変換オプションで、分かれていた Q/K/V の重みを1つの QKV テンソルにまとめます。
📖 この記事で分かること
- llama.cpp の変換ツールに
--fuse-qkvが追加された - Q/K/V の3テンソルを1つにまとめた GGUF を作れる
- 既定はオフで、対応アーキテクチャも限定される
- 速度の測定値は公表されていない
💡 知っておきたい用語
- GGUF: llama.cpp がそのまま読めるモデルファイル形式。配布用に荷物をまとめ直した箱に近い
- QKV: 注意機構が入力から作る3種類の値。同じ材料から3つの見方を切り出す下ごしらえに当たる
最終更新日: 2026年9月7日
▶ 公式ページ
- llama.cpp b10830 リリースノート(GitHub)
- Pull Request #22780(GitHub)
llama.cpp に入った --fuse-qkv とは
この記事のポイント
- ローカルLLM推論ランタイムの llama.cpp が、ビルド b10830(2026年9月時点)を2026年9月6日に公開した
- HuggingFace から GGUF へ変換するとき、層ごとの Q/K/V を1つの
attn_qkvテンソルに連結する--fuse-qkvが入った - 既定はオフ。対応アーキテクチャに限られ、速度の測定値は公表されていない
llama.cpp の変換スクリプト convert_hf_to_gguf.py に、新しいコマンドラインオプション --fuse-qkv が追加されました。ヘルプ文は「Fuse separate Q, K, V weight tensors into a single QKV tensor.」で、分かれていた Q・K・V の重みテンソルを1つの QKV テンソルにまとめる、という意味です。実装は Pull Request #22780 で、2026年9月6日にマージされ、同日公開のビルド b10830 に含まれています。変更規模は20ファイル、393行追加・122行削除です。
注意機構は入力から Q・K・V の3つを作りますが、モデルファイル上ではこれが別々のテンソルとして保存されている形式が一般的です。今回の変更は、その3つ組を変換の段階で1本の attn_qkv に連結しておく選択肢を用意したものです。重みとバイアスはそれぞれ独立に処理されます。
何がどこまで変わるのか
適用範囲は限定されています。融合済みの QKV を読み込める loader とグラフを持つアーキテクチャにだけ MODEL_TENSOR.ATTN_QKV が登録される設計で、対応していないアーキテクチャや、3つ組が揃っていない層は従来どおり非融合のまま残ります。つまりフラグを付けても、モデルによっては一部の層だけが融合される、あるいは何も変わらないことがあります。
個別の対応が入ったモデル系統として、Gemma 3n/4、JAIS 2、Kimi Linear、LLaDA、MiniMax-M2、OLMo 2/OLMoE、Qwen3.5/Qwen3-Next、Step-3.5、DeepSeek OCR が挙げられています。マルチトークン予測のグラフでは Step-3.5、Qwen3.5、Qwen3.5-MoE、Qwen3-Next が融合QKVに対応します。
読み込み側では create_tensor_qkv が、融合済みの重みがあればそれを読みます。融合された重みと分離されたままの Q/K/V バイアスが同居する旧来ファイルや独自の GGUF にも、保険として対応する作りです。今回の変更は Issue #20628 で議論された2段階の分割の後半にあたり、前半の #21245 で共通ヘルパー build_qkv / create_tensor_qkv の切り出しが済んでいました。
なお同日公開の b10828 では、新しいアーキテクチャ Spark2_5 への対応も入っています。参照モデルは XHToken/Spark-X2.5-1.7B(Apache-2.0、2026年9月時点)で、このモデル自体が融合されたQKV射影を使う構成です。
使う前に押さえる3つの条件
第一に、既定はオフです。action="store_true" のオプトインとして実装されているため、フラグを付けなければ変換の挙動は従来と変わりません。既存の手順をそのまま回している場合、何もしなくても影響は出ない設計です。
第二に、出力の数値が完全に一致するとは限りません。PR は、融合された行列積は3回に分けた行列積と実行経路が異なりうるため、数値の完全一致はバックエンド依存であり、アクセラレータ上の出力は通常の浮動小数点誤差の範囲でずれうる、と明記しています。
第三に、速度の測定値は示されていません。PR に速度倍率やスループット改善率の数字はなく、公表されているのは検証の内容です。具体的には、test-llama-archs が対応アーキテクチャすべてで通過したこと、PyTorch 2.6.0(2026年9月時点)でフラグの有無それぞれ実際に変換を実施したこと、小さな Llama フィクスチャの各層で融合テンソルを concat(Q, K, V) と要素単位で照合したこと、llama-bench の pp8 と tg8 が完走したこと、ヘルパー整理の前後で主要グラフ7本とMTPグラフ4本の logits ハッシュが完全に一致したことが挙げられています。
編集部の見方
編集部は、この変更でいま効くのは速度ではなく、同じモデルから融合版と非融合版を作り分けられるようになったことだと見ています。今すぐ全員が付けるべきフラグではありません。
- 根拠1: 既定がオフのオプトインで、対応アーキテクチャにも限りがある。付けても層によっては非融合のまま残るため、「変換手順を一律で書き換える」判断材料が現時点では足りません。
- 根拠2: PR に速度の測定値が一切示されていません。融合の狙いが実行経路の集約にあるとしても、環境ごとの効果は自分で測るしかない段階です。
- 根拠3: 出力の数値一致がバックエンド依存だと明記されています。回帰テストで出力ハッシュを固定している運用では、融合版に切り替えた時点で差分が出る可能性を先に見ておく必要があります。
この見方が変わる条件は、対応アーキテクチャが広がり、環境別の実測値が公開されたときです。数字が出て初めて、既定化や配布 GGUF の作り分けを議論する段階に入ります。
よくある質問
Q: 既存の GGUF ファイルは作り直しが必要ですか
A: 不要です。--fuse-qkv はオプトインのオプションで、付けなければ変換の挙動は従来どおりです。読み込み側も融合済みの重みがある場合にそれを読む作りになっています。
Q: フラグを付ければどのモデルでも QKV が1本になりますか
A: なりません。融合QKVを読める loader とグラフを持つアーキテクチャだけが対象で、対応外のアーキテクチャや3つ組が揃っていない層は非融合のまま残ります。
Q: 融合すると出力は変わりますか
A: 完全一致は保証されていません。PR は、融合された行列積が3回に分けた行列積と実行経路が異なりうるため、数値の一致はバックエンド依存で、アクセラレータ上の出力は通常の浮動小数点誤差の範囲でずれうると説明しています。
まとめ
llama.cpp のビルド b10830 で、HuggingFace から GGUF への変換時に Q/K/V を1つの attn_qkv テンソルへ連結する --fuse-qkv が追加されました。既定はオフ、対応アーキテクチャは限定、速度の測定値は非公表という3点が現時点の条件です。出力の数値一致がバックエンド依存である点は、変換手順を変える前に確認しておく価値があります。
【用語解説】
- テンソル: モデルの重みを格納する多次元の数値の集まり。ここでは Q・K・V それぞれの重みが個別のテンソルとして保存されている状態を指す
- loader: GGUF ファイルからテンソルを読み出してモデルを組み立てる部分。融合済みの重みに対応しているかどうかが、今回の適用範囲を決めている
- マルチトークン予測: 一度の推論で複数のトークンをまとめて予測する方式。llama.cpp では専用のグラフが用意されており、今回その一部が融合QKVに対応した
引用元:
- [1] llama.cpp b10830 リリースノート(GitHub)
- [2] convert : add
--fuse-qkvflag to fuse Q/K/V into QKV during HF-to-GGUF conversion(PR #22780)(GitHub) - [3] convert_hf_to_gguf.py(タグ b10830 時点)(GitHub)
- [4] llama.cpp b10828 リリースノート(GitHub)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
ロボット物理シミュのGenesis 1.4.0、不具合を1ファイルで再現。剛体ソルバのみ対応


Next Post
Googleが飛行機雲をAIで避ける実証。80便超で温暖化影響を約4割減と推定

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。