


📖 この記事で分かること
- @mastra/mcp に実験的な MCP タスク機能が入った
- 長時間処理がタスクを即時返却し、別インスタンスから操作できる
- 共有ストレージがあれば再起動を越えてタスクが残る
- 実行中インスタンスの停止時は既定で失敗扱いになる
💡 知っておきたい用語
- MCP タスク:時間のかかる処理に「受付番号」を返し、あとから進み具合を確かめたり取り消したりできる仕組み
最終更新日: 2026年11月3日
▶ 公式ページ
- @mastra/core 1.81.0 リリースノート(GitHub)
- Introducing MCP 2.0 ブログ(Mastra 公式ブログ)
Mastra 1.81.0 で MCP の長時間タスクはどう変わるか
この記事のポイント
- Mastra が 11 月 2 日に @mastra/core 1.81.0(2026年11月時点)を公開し、@mastra/mcp に実験的な MCP タスク機能を追加しました。
- 長時間かかるツール・エージェント・ワークフローがタスクを即時返却し、複数インスタンスからポーリング・回答・キャンセルできます。
- 共有ストレージがあればタスクは再起動後も残りますが、実行中インスタンスの停止時は既定で失敗扱いになります。
Mastra で MCP サーバーを公開し、数分かかるワークフローやエージェントをツールとして提供している開発者にとっては、その処理を 1 本の接続に縛らずに扱えるようになる更新です。MCP(Model Context Protocol、AI エージェントが外部のツールやデータにつなぐための共通規約)の Tasks を、Mastra 側のストレージで保持する形で実装したもので、リリースノートは「実験的」と位置づけています。
Mastra は TypeScript 製の AI エージェントフレームワークで、@mastra/mcp がその MCP サーバー・クライアントの実装にあたります。今回の 1.81.0 では、この @mastra/mcp に「Mastra ストレージを裏付けとする実験的な MCP タスク」が追加されました。
追加された機能の中身
結論から言うと、長時間処理をタスク化してストレージに置き、どのインスタンスからでも扱えるようにした機能です。
リリースノートが挙げている内容は次のとおりです。
- 長時間かかるツール・エージェント・ワークフローは、処理の完了を待たせずにタスクを即時返却できる。
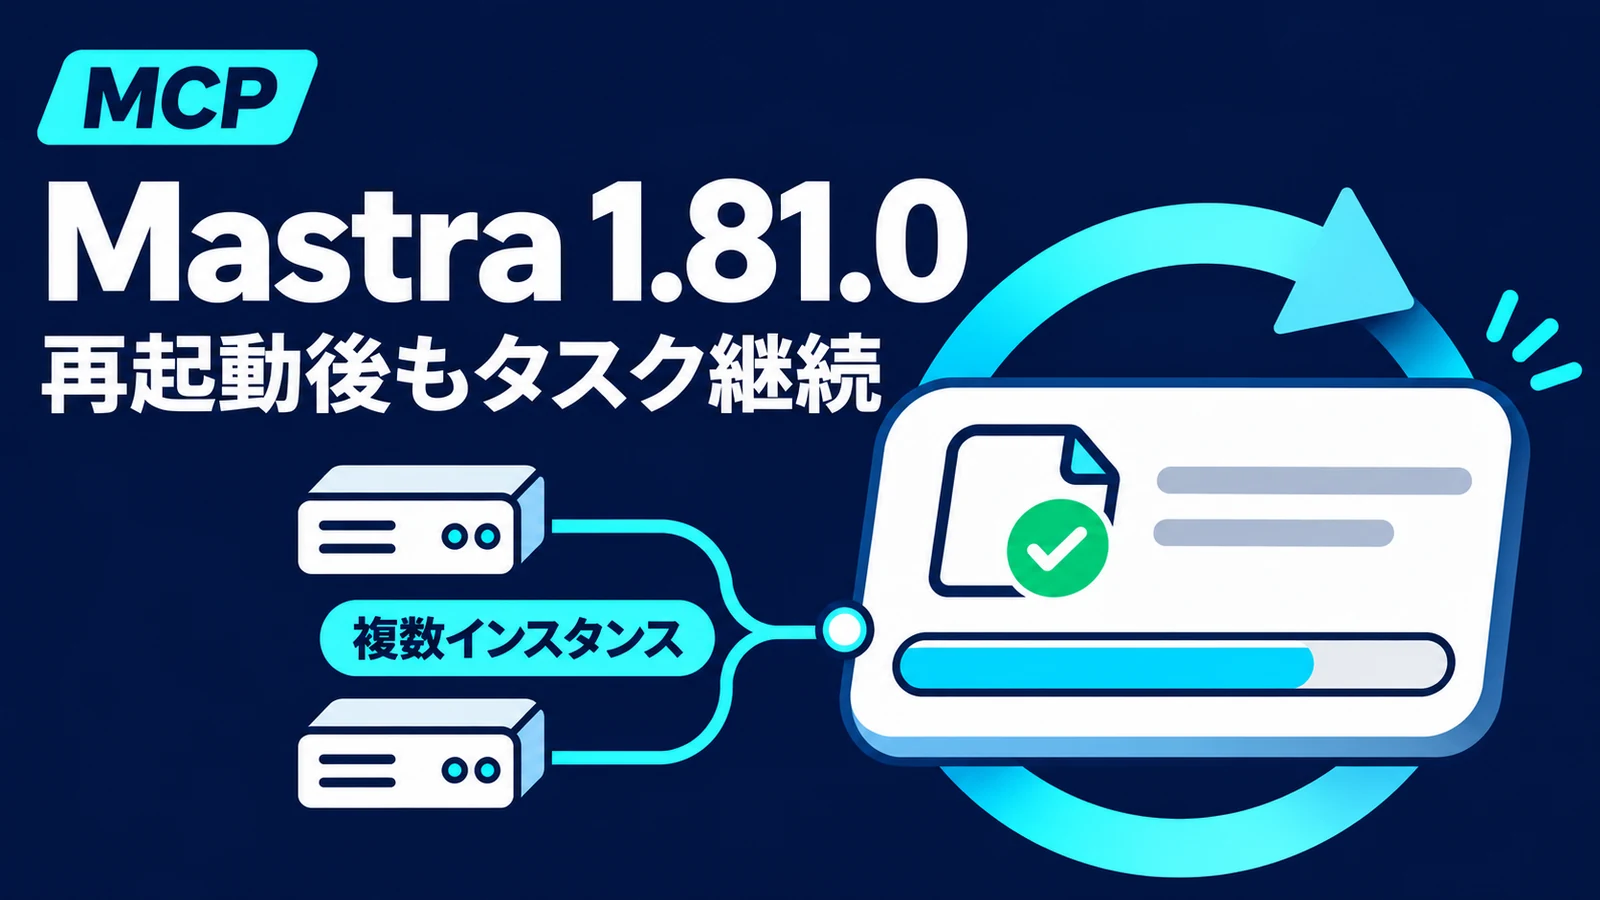
- そのタスクは複数インスタンスをまたいでポーリング(進み具合の確認)・回答・キャンセルできる。
- 共有ストレージを使えば、タスクは再起動を越えて残る。トレーシングも統合される。
仕組みの前提として、バックグラウンドタスクを有効にして Mastra インスタンスに登録したサーバーが、タスクを Mastra ストレージに保持します。回答はそれを受け取ったインスタンスが停止しても残り、各インスタンスはサーバー登録と同時に、停止したインスタンスが残したタスクを引き継ぐと説明されています。
一方で制限もはっきり書かれています。タスクを実行中のインスタンスが停止した場合、そのタスクは既定では失敗扱いになります。「回答が残る」ことと「実行中の処理が引き継がれる」ことは別で、後者は既定の挙動ではありません。
10 月の MCP 2.0 対応からの続報
この機能は、Mastra が 10 月 21 日に公開した MCP 2.0 対応のブログで予告していた部分の続きにあたります。
同ブログで Mastra は、MCP の Tasks が「以前は実験的機能だったが、公式拡張になった」と説明していました。そのうえで、@mastra/mcp でのタスク対応については「選択肢を検討中」としていました。1.81.0 はその検討の結果として出てきた最初の実装で、Mastra 側でもなお「実験的」の扱いです。
開発者の作業場面で何が起きるか
結論として、ロードバランサの後ろに Mastra インスタンスを複数並べて MCP サーバーを公開している構成で、効き方がいちばん分かりやすい更新です。
たとえば、社内の大量ドキュメントを読み込んで要約レポートを組み立てるワークフローを、MCP のツールとしてエージェントに公開しているとします。処理には数分かかり、インスタンスは 3 台で動いている、という場面です。1.81.0 の機能を有効にすると、クライアントの呼び出しはタスクを即時に受け取り、進み具合の確認やキャンセルを、最初に受け付けたインスタンスと別のインスタンスに対して投げても成立します。回答を受け取ったインスタンスがデプロイで入れ替わっても、回答そのものは共有ストレージに残ります。
ただし、デプロイのタイミングでまさに要約処理を走らせていたインスタンスが止まると、そのタスクは既定では失敗になります。ローリングデプロイの最中に走っていた処理をどう扱うかは、この既定の挙動を踏まえて設計する必要があります。
次にできることとしては、共有ストレージを既に Mastra に接続している環境であれば、ステージングで実験的機能として有効にし、インスタンス停止時のタスクの状態を確かめるのが現実的です。本番導入の判断は、「実験的」の表記と、停止時に既定で失敗する挙動の 2 点を前提に置いたうえで行うことになります。有効化の設定項目や対応ストレージの範囲は本記事では扱わないので、リリースノートの本文で確認してください。
編集部の見方
編集部は、この更新の価値は「再起動を越えて残る」ことより、タスクの操作がインスタンスに縛られなくなる点にあると見ています。
- 根拠 1: リリースノートが挙げる機能のうち、ポーリング・回答・キャンセルを「複数インスタンスをまたいで」行えることは、水平スケールした MCP サーバーでそのまま効く差分です。単一インスタンスの構成では、この部分の恩恵は限られます。
- 根拠 2: 「再起動を越えて残る」と書かれているのはタスクと回答であって、実行中の処理ではありません。実行中インスタンスの停止時は既定で失敗すると明記されているので、耐障害性の機能としてはまだ限定的です。
- 根拠 3: Mastra 自身が 10 月のブログで「選択肢を検討中」としていた段階から、1.81.0 でも「実験的」の位置づけを変えていません。本番の信頼性を前提にした設計に組み込む段階ではないと判断します。
この見方が変わる条件は、実験的の表記が外れ、インスタンス停止時のタスク引き継ぎが既定の挙動になった時です。その時点で、この機能は「操作の分散」から「長時間処理の耐障害性」へ役割が広がります。
よくある質問
Q: 1.81.0 の MCP タスク機能は本番環境で使える品質ですか?
A: リリースノートは「実験的」と位置づけています。実行中インスタンスの停止時にタスクが既定で失敗する点も明記されているので、本番での採用はその前提で判断する必要があります。
Q: 再起動後にタスクが残るには何が必要ですか?
A: リリースノートは「共有ストレージを使えば」再起動を越えて残るとしています。バックグラウンドタスクを有効にして Mastra インスタンスに登録したサーバーが、タスクを Mastra ストレージに保持する仕組みです。
Q: MCP の Tasks そのものは標準の機能ですか?
A: Mastra の 10 月 21 日のブログは、Tasks が「以前は実験的機能だったが、公式拡張になった」と説明しています。1.81.0 は、その Tasks を @mastra/mcp で扱う Mastra 側の実装です。
まとめ
Mastra は 11 月 2 日に @mastra/core 1.81.0 を公開し、@mastra/mcp に Mastra ストレージを裏付けとする実験的な MCP タスク機能を加えました。長時間処理がタスクを即時返却し、複数インスタンスからポーリング・回答・キャンセルでき、共有ストレージがあれば再起動後も残ります。一方、実行中インスタンスの停止時は既定で失敗扱いになるため、水平スケール構成での操作の分散には効く反面、耐障害性の機能としては限定的です。
【用語解説】
- ポーリング: 処理が終わったかどうかを、呼び出す側が繰り返し問い合わせて確かめる方式。
- 共有ストレージ: 複数のインスタンスが同じデータを読み書きできる保存先。1.81.0 ではタスクと回答の置き場所になる。
- トレーシング: 処理がどこを通り、どこで時間がかかったかを追跡して記録する仕組み。
引用元:
- [1] @mastra/core 1.81.0 リリースノート(GitHub)
- [2] Introducing MCP 2.0(Mastra 公式ブログ)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。


15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。