


📖 この記事で分かること
- GLM-Legalの規模と構成(総320B・稼働18B)
- Harvey LABで19.2%という成績の読み方
- Z.aiが性能を主張している範囲は中国法
- 評価前に確かめるべき条件と未確認点
💡 知っておきたい用語
- MoE:質問ごとに、モデル内の一部の専門家だけを呼び出して答える構成。全員を毎回動かさないので計算が軽くなる
最終更新日: 2026年10月14日
▶ 公式ページ
- GLM-Legal 発表ブログ(Z.ai)
GLM-Legalの概要
この記事のポイント
- Z.aiが2026年10月13日、法律特化モデルGLM-Legal(2026年10月時点)を発表しました。
- 総320B・推論時18BのMoE構成で、Harvey LABの全項目合格率は19.2%です。
- 性能の主張は中国法が中心で、API利用は申請制です(2026年10月時点)。
法律文書や法律相談の基盤モデルを選ぶ開発者は、1回の推論で動くのが18B分だけという軽さの法律特化モデルを、申請を経て評価候補に加えられるようになりました。Z.aiが2026年10月13日に発表した「GLM-Legal」で、Z.aiは中国法の法律相談・事例分析・文書作成で最先端システムと同等の性能に達したと説明しています。ただし性能の主張は中国法が中心のため、日本法の業務で使えるかは、自社の課題で測り直すまで判断できません。
API利用は申請制です。誰でもすぐ呼び出せる形ではないため、評価を始めるまでの申請の時間も見込んでおく必要があります。
仕様と性能の主張
数字で押さえるべきは、モデル規模と法律実務ベンチマークの2点です。
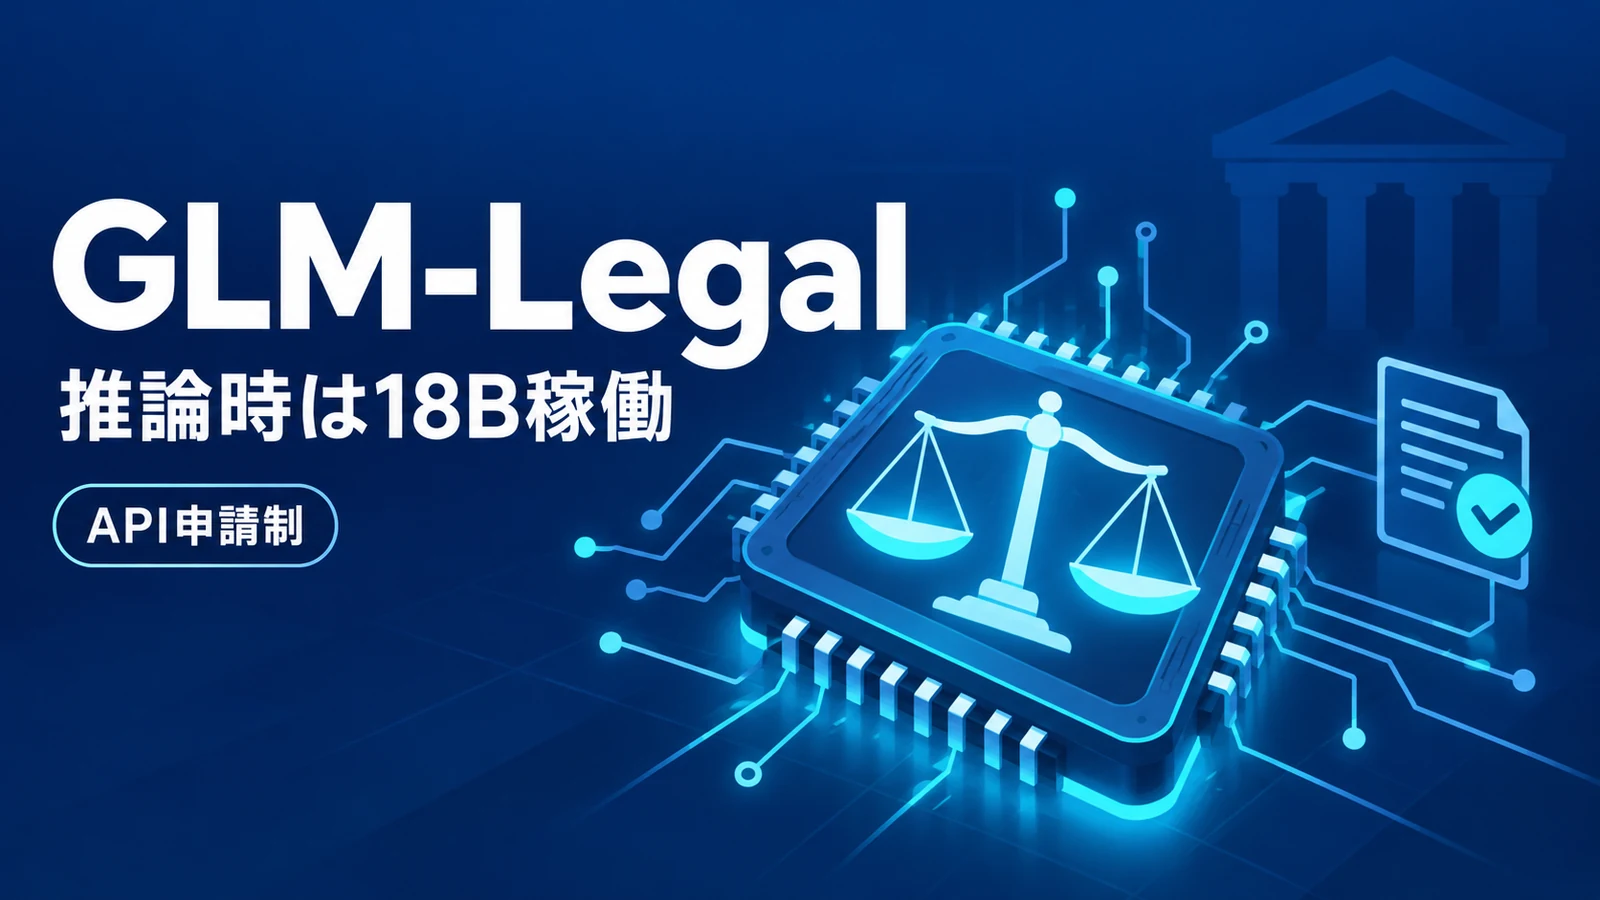
GLM-Legalは総パラメータ320B、推論時に実際に動くアクティブパラメータ(1回の推論で計算に使われる部分)が18BのMoE【エムオーイー】構成です。Z.aiは発表で「320Bの総パラメータに対し、アクティブは18Bのみで高い性能を出す」と書いています。
性能面では、法律実務ベンチマークのHarvey LAB(法律事務所の実務に近い課題で、評価項目をすべて満たせるかを見る指標)で、全項目合格率19.2%を記録しました。ベースモデルからは12.5ポイントの改善です。
Z.aiが「最先端システムと同等」と主張している領域は、次の3つで、いずれも中国法が対象です。
- 法律相談
- 事例分析
- 文書作成
誰の判断に関わるか
Z.aiは想定利用者として、法律事務所、リーガルテック企業、企業法務部、個人の実務家を挙げています。使用例の1つには、シンガポール・マレーシア・インドネシアで公開するWebサイトのプライバシー対応計画を示しています。複数の国にまたがる規制の論点を洗い出す下調べのような用途を想定していることが分かります。
技術者が評価を検討するなら、次の点を先に確かめておくと判断がぶれにくくなります。
- 自社が扱う法域(日本法など)の課題で、Z.aiの主張が中国法向けである点をどう補うか
- 申請制のAPIで、申請の条件や利用規約、データの扱いがどうなっているか
- Harvey LABの19.2%を、自社の課題でどう測り直すか
なお、料金や申請の具体的な条件は、本記事の材料では確認できていません。公式ページで最新の記載を確かめてから評価計画を立てるのが確実です。
編集部の見方
編集部は、このモデルで最初に評価すべき点は「法律の正答力」より、18Bしか動かない軽さで法律特化の性能がどこまで出るかだと見ています。
- 根拠1: 総320Bに対し推論時は18Bの構成で、Z.ai自身も規模を抑えた点を強調しています。社内で大量の文書を回す法務基盤では、推論の重さが採用可否を左右しやすいからです。
- 根拠2: Harvey LABの全項目合格率19.2%は、ベースモデルから12.5ポイント伸びた一方で、裏返せば課題の8割強では評価項目を満たし切れていない水準です。出力をそのまま使う前提ではなく、人が確認する下書きとして位置づけるのが妥当です。
- 根拠3: 性能の主張は中国法の相談・事例分析・文書作成に限られています。日本法の業務に使えるかは、発表の主張からは判断できません。
この見方が変わる条件は、Z.aiが中国法以外の法域で同等の評価結果を示した場合です。そのときは「軽い法律特化モデル」から「多法域で使える選択肢」へ評価を上げられます。
よくある質問
Q: GLM-Legalは日本法の業務に使えますか?
A: Z.aiが最先端システムと同等と説明しているのは、中国法の法律相談・事例分析・文書作成です。日本法での性能は、発表の主張からは判断できないため、自社の課題で検証する必要があります。
Q: 誰でもAPIで使えますか?
A: API利用は申請制です。申請の条件や料金は、公式ページで最新の記載を確認してください。
Q: Harvey LABの19.2%は高いのですか?
A: ベースモデルからは12.5ポイント改善しています。ただし全項目を満たした課題が2割弱という意味でもあり、出力は人の確認を前提にした扱いが現実的です。
まとめ
Z.aiのGLM-Legalは、総320B・推論時18BのMoE構成をとる法律特化モデルで、Harvey LABの全項目合格率は19.2%です。性能の主張は中国法が中心で、API利用は申請制です。日本の法務で評価するなら、対象法域と申請条件を確かめたうえで、自社の課題で測り直すことが出発点になります。
【用語解説】
- アクティブパラメータ: モデル全体のパラメータのうち、1回の推論で実際に計算に使われる部分。少ないほど推論は軽くなる
- Harvey LAB: 法律実務に近い課題で、回答が評価項目をすべて満たすかを測るベンチマーク
- 全項目合格率: 課題ごとの評価項目をすべて満たした割合。一部だけ満たした回答は合格に数えない
引用元:
- [1] GLM-Legal(Z.ai)
この記事について: AI 支援で執筆、編集部が事実確認・編集しています。誤りや追加情報があれば Contact よりお知らせください。
Previous Post
生成AIニュース 昨日【2026年10月14日(水)】のAI公式発表を3分でチェック


Next Post
声を失った英上院議員、ElevenLabsで再現した自分の声で演説。英議会で初

15 年以上の開発経験を持つソフトウェアエンジニア / テクノロジーライター。AI エージェントの実務活用を研究し、現場や経営者向けセミナーでその知見を発信。本メディア tech-noisy.com では、一次情報に基づく最新ニュース・解説記事を執筆。また、音楽生成 AI による DJ パフォーマンスを企業イベントで行うなど、テクノロジーと表現の融合も探求している。